• Snowflake初心者の私が、最初にやってよかったこと

    Snowflakeを勉強し始めたとき、私は「結局、何から勉強すればいいんだろう?」という状態でした。

    この記事では、そんな私が実際にやってみて分かりやすかった学習の進め方を紹介します。

    これからSnowflakeを学ぶ方や、公式ドキュメントを読んでいても使い方のイメージがつかめない方の参考になればと思います。

    また、分かってはいたけど、改めて論点の重要性に共感していただけると幸いです。

    資格試験のための公式ドキュメントの勉強はハードルが高い

    Snowflakeにはいろいろな機能があります。調べ始めると、次のような知らない言葉がたくさん出てきました。

    • Cortex
    • AI Agent
    • Streamlit
    • Iceberg
    • Horizon
    • Lineage

    始めたばかりの私には、名前は見かけて意味もざっくり分かるけれど、いまいちピンとこない。

    ひとつ調べると、その説明の中にまた知らない言葉が出てきます。それを繰り返しているうちに、自分が何を分かっていて何を分かっていないのかも分からなくなって迷走しがちです。

    ここで挫折する方も多いのではないでしょうか。

    今思うと、このころの私は機能の名前と説明ばかりを追いかけていて、「それを使って何ができるのか」が見えていなかったのだと思います。

    Snowflake World Tourにリモート参加して理解が飛躍的に上がりました

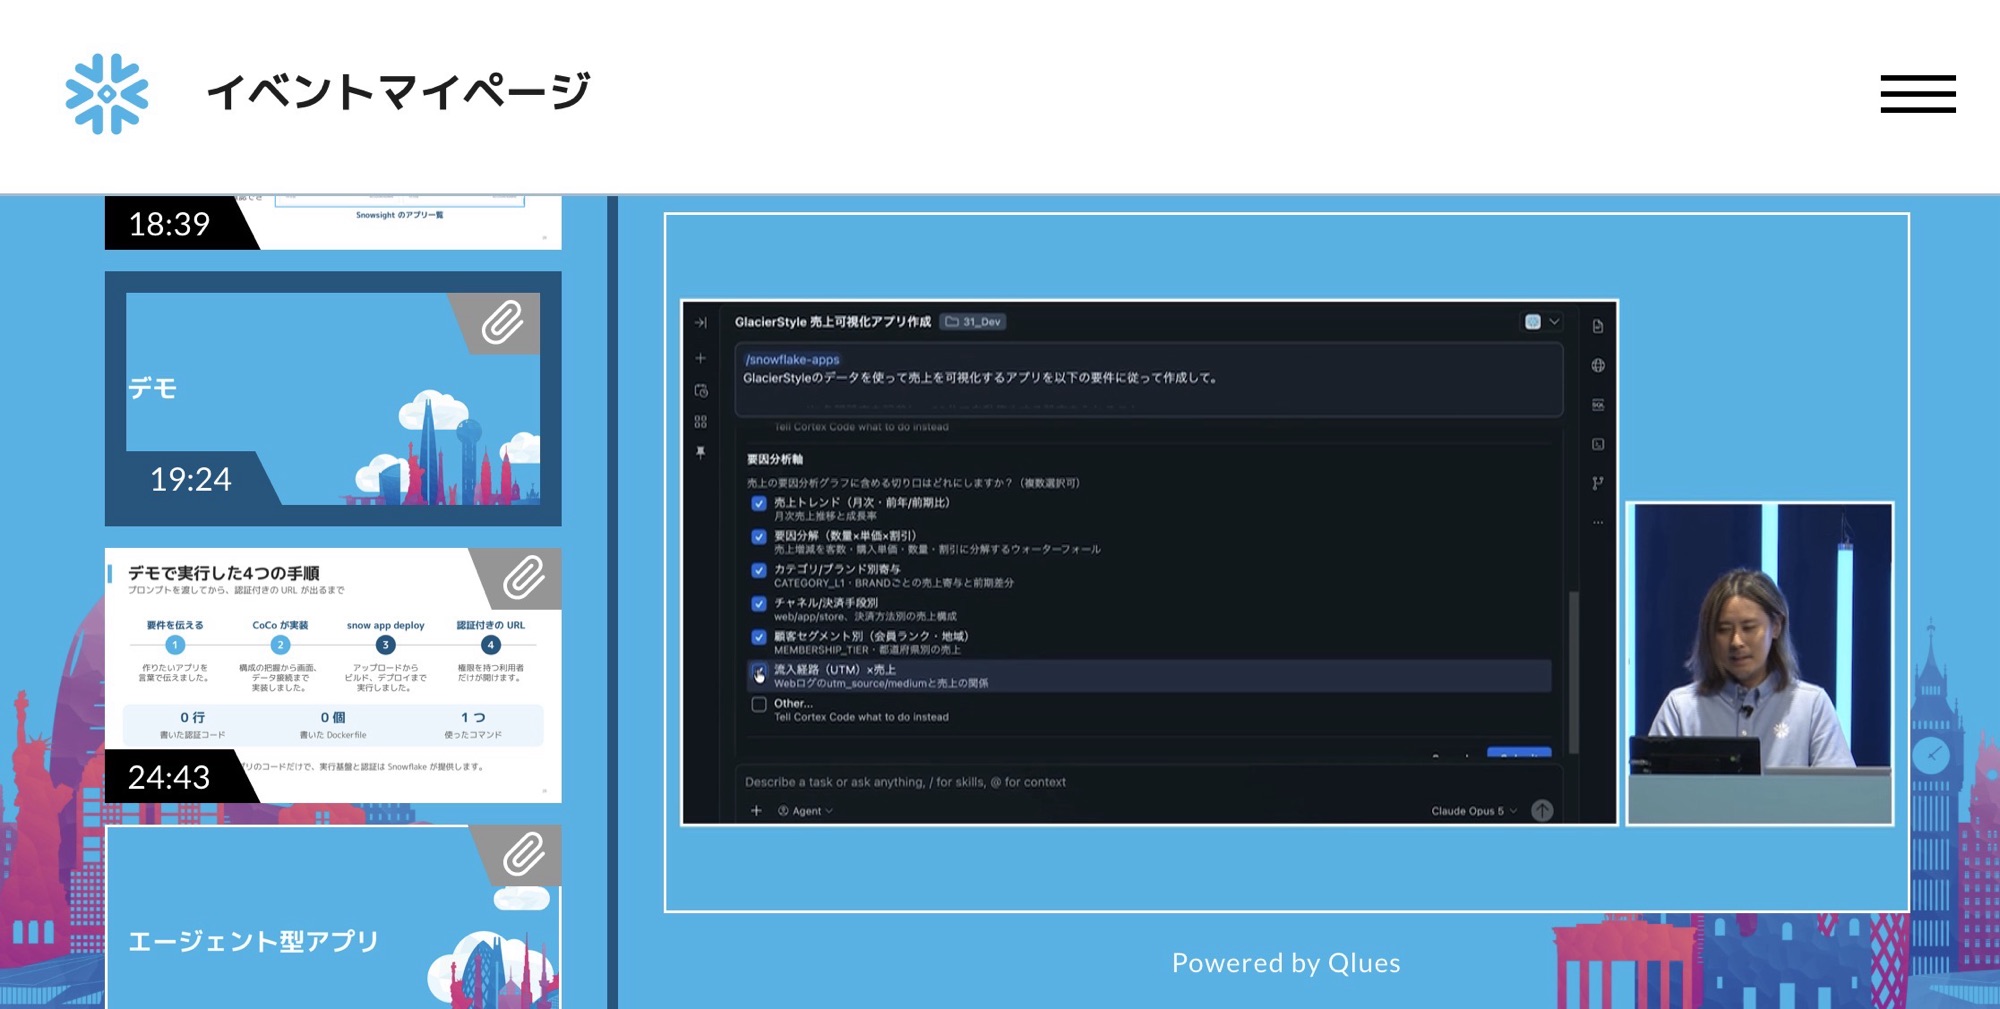
    そんな中で特に役に立ったのが、Snowflakeのイベント「Snowflake World Tour」にリモートで参加したことです。

    イベントでは、機能の説明だけでなく、実際にSnowflakeを使ってアプリケーションを作ったり、最新情報と共にAI AgentやCortexなどを使った実装を紹介したりする動画やセッションがありました。これが私にとって、とても参考になりました。

    説明を読むより、作っているところを見るほうが分かりやすかった

    イベントに参加して一番感じたのは、実際に何かを作っているところを見るほうが理解しやすい、ということです。

    たとえばAI Agentについて、文章だけで調べていたときは、なかなかイメージできませんでした。説明を読んで、その時は分かったような気はするのですが、まだ理解はできてません。

    ところが、Snowflake上でアプリケーションを作り、そこにAI Agentなどを組み込んでいる様子を見ると、「なるほど、こういうことができるのか」と具体的にイメージできるようになりました。

    実装を見ると、その機能がアプリの中のどこで、何のために使われているのかが分かります。

    私の場合は、この「使われている場面」が見えるかどうかで、理解のしやすさが段違いでした。

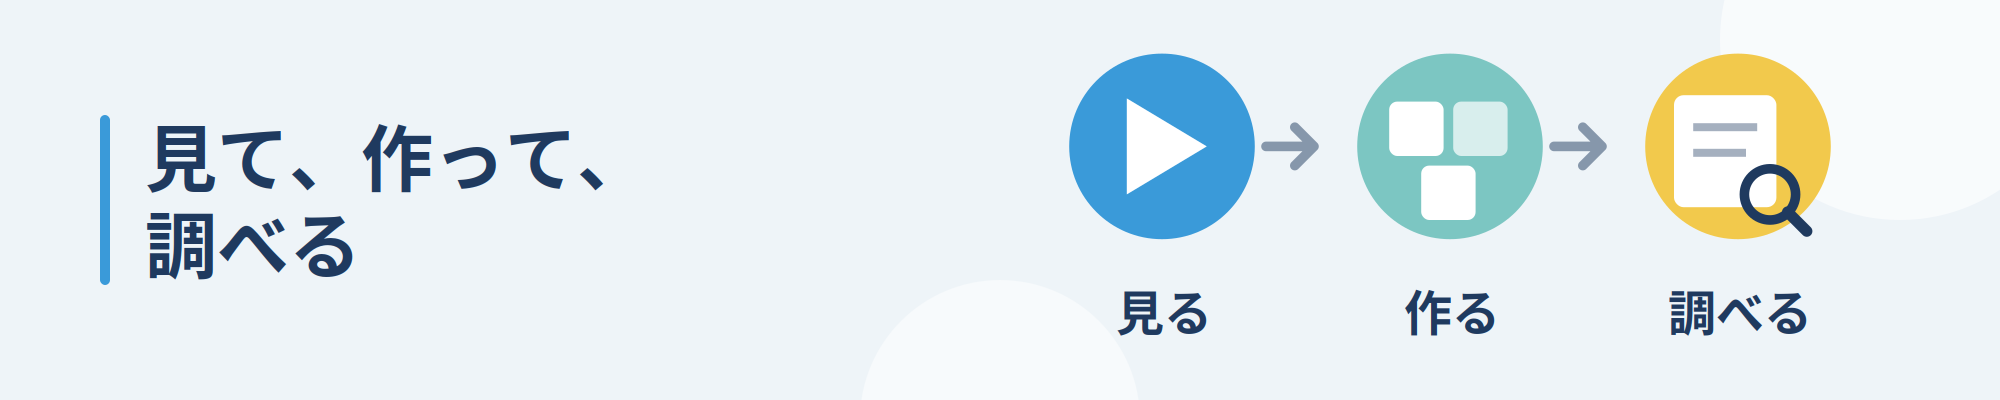
    私に合っていたのは「見る → 作る → 調べる」という流れでした

    イベントをきっかけに、私の学習は次のような流れになりました。

    1. 動画を見る

    ↓

    2. Snowflakeで実際にアプリを作ってみる

    ↓

    3. 分からないところが出てくる or 裏で動く仕組みを知りたくなる

    ↓

    4. 公式ドキュメントで調べて仕組みを知る

    最初に公式ドキュメントを全部読んで理解してから開発する、というやり方もあると思います。ただ私の場合は、まず作ってみて、分からないところが出てきたら公式ドキュメントを調べる、というほうが合っていました。

    知りたいことが決まっていると、ドキュメントが読みやすくなります

    この流れのよいところは、公式ドキュメントを開くときに、何を知りたいのかがはっきりしていることだと思います。

    何も分からない状態で、ドキュメントを読むと、どこが大事なのか判断しにくく、情報量の多さに圧倒されてしまいます。

    一方で、実際に作ってみて「ここが分からない」という疑問を持ってから読むと、必要なところに自然と目が向きます。

    ドキュメントの内容は同じでも、読むタイミングを変えるだけで、ずっと頼りになるものになります。

    アーカイブ動画を触ってから見直すとさらに効果的です!

    Snowflake World Tourなどのイベントにはアーカイブがあり、あとから動画を見直せます。これも学習するうえでありがたかった点です。World Tour以外のイベントも含めて、Snowflakeのイベント情報はこちらのページにまとまっています。

    一度見たときには分からなかった内容も、Snowflakeを触ってからもう一度見ると、「この話はこういうことだったのか」と理解できることがありました。

    そのため、最初に見たときに全部理解できなくても、あまり気にしなくていいと思います。少し触ってから見直すつもりで、最初は気軽に見てみるくらいでちょうどいいのかもしれません。

    これからSnowflakeを学ぶ方へ

    最後に、私がSnowflakeを学ぶうえで分かりやすかった進め方をまとめます。

    • 最初から機能を全部覚えようとせず、知らない言葉が多くても気にしない
    • まず実際のアプリケーションやデモを見て、Snowflakeで何ができるのかを知る
    • 見たものを参考に、自分で作ってみる
    • 分からないことが出てきたら、公式ドキュメントで調べる
    • 少し触ってから、アーカイブ動画を見直す

    もちろん、これは私に合っていた方法で、分かりやすい学び方は人それぞれだと思います。

    それでも、もし今「何から勉強すればいいか分からない」「ドキュメントを読んでもイメージがわかない」と感じているなら、一度、誰かが実際にSnowflakeで何かを作っている様子を見てみることをおすすめします。

  • 社内文書を対象とした Agentic RAG コンペ(SIGNATE)に取り組んだ記録です。
    方針から設計、実装の2経路(API版と完全ローカル版)、現場で踏んだ罠、PDCA、工夫まで、一本で追えるようにまとめました。
    これから同種のシステムを作る人が、読んでそのまま再現できることを目指して作成しました。
    長編です。笑

    課題は、架空のデータ分析コンサル会社「データアステル社」の共有ドライブを対象に、寄せられる質問へ根拠に基づいて日本語で回答する RAG システムを作り、回答精度を競うものです。

    今回のRAG コンペにおいて重要視されている点としては、
    新規の案件フォルダ・新規の資料の追加によって、回答精度が変わらないこと。

    つまり「既存データによって最適化された検索」ではなく、「未知のデータでも同じ検索結果を出力する汎用システムを作る」ことがゴールとなります。

    0. 全体アーキテクチャ

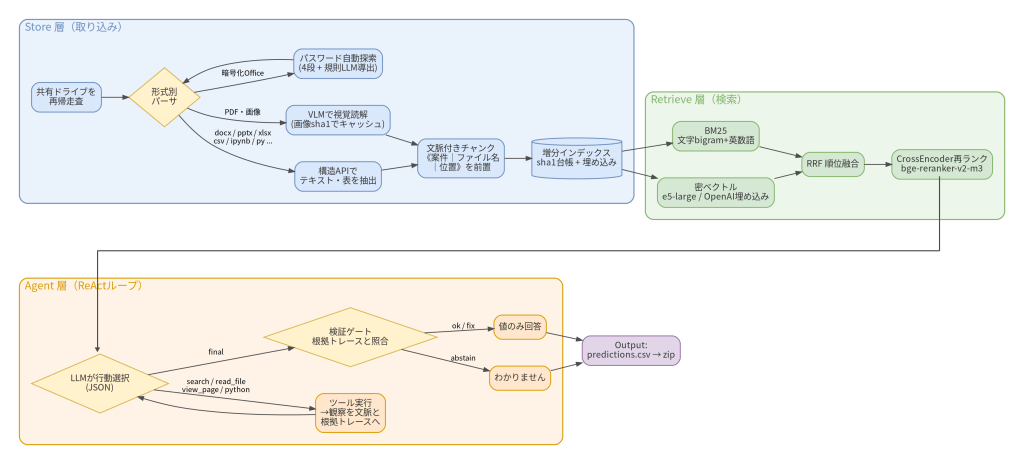
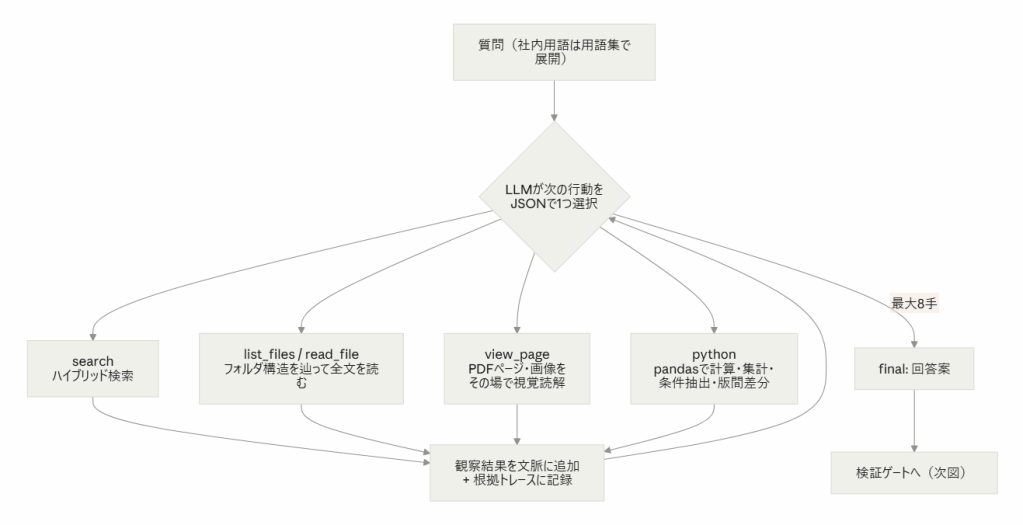
    まず完成形の全体像です。Store / Retrieve / Agent / Output の4層構成で、LLM バックエンドは OpenAI API とローカル Ollama を設定1つで切り替えられます。

    この構成に至るまでの判断を、順に説明していきます。

    1. 方針 — コードより先に、評価コードと論文を読む

    最初に着手したのは実装ではなく、配布された評価コードの解読でした。

    1-1. 採点 LLM は「質問文を見ない」

    本コンペの評価は Meta の CRAG ベンチマーク [1] に準拠した LLM 採点で、回答を Perfect(+1) / Acceptable(+0.5) / Missing(0) / Incorrect(-1) に分類し、平均をスコアとします。評価コードを読むと、採点プロンプトに渡されるのは

    ground_truth: {模範解答} answer: {提出回答}

    のみで、質問文は渡されません。「契約金額はX円です。契約書第5条に記載され…」のような丁寧な回答は、模範解答「X円」との文字列比較で不利になり得ます。回答は”値そのもの”だけを、模範解答と同じ形式で出すのが最適解となります。

    1-2. 得点の非対称性から「賭け方」を決める

    判定得点条件
    Perfect+1完全に正しい
    Acceptable+0.5軽微な誤りのみ(数値は指定桁への丸め一致に限る)
    Missing0「わかりません」等の無回答
    Incorrect-1誤り・無関係

    重要な非対称性が2つ。要素列挙問題は部分一致でも即 Incorrect(-1)、Acceptable なし。そしてMissing は 0 点。誤答の -1 に対し、自信がないときの「わかりません」は 0 で止血できます。

    1-3. 方針の4原則

    1. 評価仕様からの逆算 — 回答は値のみ・1行・列挙は「、」区切り・不確実なら「わかりません」
    2. 汎用性最優先 — フォルダ名・ファイル名・値からのハードコードをなくす。実行時にドライブから機械検出を行う。
    3. 検索+計算 — 「CSV を条件抽出して集計」「版間差分」型の問題が確実に存在。LLM の暗算ではなくコード生成+実行で計算
    4. 再現性 — temperature=0・seed 固定・全 LLM 呼び出しの JSONL ログ・使用モデル名の記録

    2. 設計 — 4層それぞれの中身

    2-1. Store — パース品質が RAG 全体の性能を決める

    「OCR・パースの品質が下流性能をどれだけ律速するか」は OHRBench が体系的に示した論点で、Store の手抜きは後段で取り返せないという本設計の前提を裏付けます。本件は配布データが Office 系中心(構造化 API で正確に読める)なので、pptx/docx/xlsx はライブラリで直接パースし、PDF・画像のみ VLM 読解に回すハイブリッドにしました。

    画像・グラフの扱いは設計の分岐点でした。ページ画像そのものを検索対象にする方式と、VLM でテキスト化してからテキスト検索に載せる方式がありますが、本パイプラインは後者を採りました。(a) 既存の BM25+密ベクトル・増分インデックスをそのまま活かせる、(b) 生成キャプションを画像バイト列の sha1 でキャッシュでき再実行時の再課金・再計算がゼロ、(c) 重い検索モデルを持ち込まずに済む、が理由です。ページ画像検索の利点は、後述の view_page ツールで補完します。

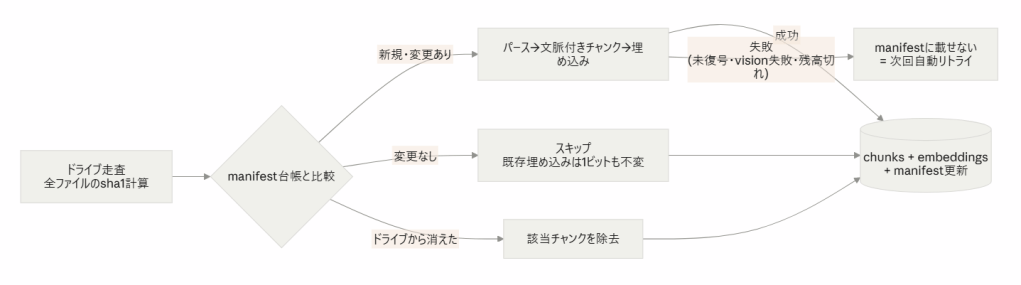
    インデックスは増分設計です。ファイルごとの台帳を持ち、追加・変更分だけをパース・埋め込みします。「新規フォルダを追加しても既存チャンクの埋め込みが1ビットも変わらない」ことをテストで実証しており、検収時のデータ追加が既存の検索品質を揺らさない根拠になっています。
    失敗したファイル(未復号・画像読解失敗)は台帳に載せない=次回実行時に自動リトライという一貫した規則で、中断・再開にも同じ仕組みで対応します。

    さらに各チャンク本文に 《案件名|ファイル名|位置》 という出典コンテキストを前置してから索引化します。チャンク単体で失われる文書レベルの文脈を埋め込み・BM25 双方に効かせるこの手法は、Anthropic の Contextual Retrieval の軽量版です。原典は LLM でチャンクごとの説明文を生成しますが、メタデータの機械的前置だけでも「案件名+項目名」型クエリのマッチが明確に改善しました。

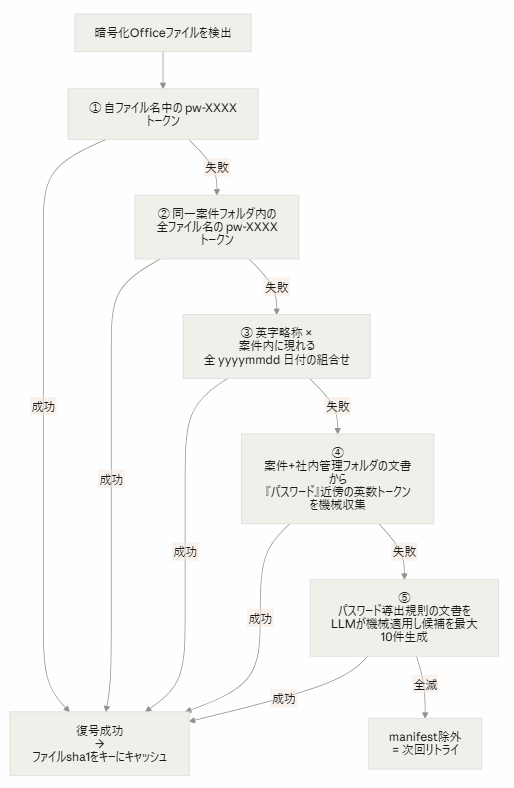
    暗号化 Office ファイルへの対応は、ハードコード禁止下では「実行時にドライブから候補を機械生成して試す」一択です。候補生成は4段+LLM導出の5段構えにしました。⑤が効くのは「パスワードそのものはどこにも書かれていないが、導出規則の文書は存在する」ケースです。規則文書の内容は実行時に読むため、新規案件にも同一処理で一般化されます(特定パスワードの埋め込みではないのでルール適合です)。

    2-2. Retrieve — スコアではなく「順位」で融合する

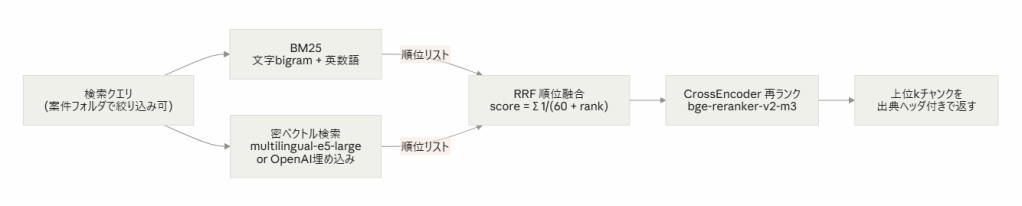
    日本語×専門用語×英字識別子(列名やタスクID)が混ざるコーパスなので、キーワード検索(BM25、形態素解析器なしで動く文字 bigram+英数語トークナイザ)と意味検索(埋め込み)のハイブリッドにし、RRF(Reciprocal Rank Fusion) で融合しました。

    RRF は学習不要・スコア校正不要で個別ランカーを上回るという原論文の性質が「新規フォルダ耐性」に直結します。BM25 のスコア分布はコーパス増加で変わりますが、順位ベースの融合はスケール変化に影響されません。

    2-3. Agent — 静的パイプラインではなくツールループ

    「検索して詰めて生成する」静的 RAG に対し、計画・ツール使用・自己修正を行う Agentic RAG の枠組みは Singh らのサーベイ に整理されています。本件は単一資料の読解から複数案件の照合・集計まで難度の幅があり、固定フローでは過不足が出ます。そこで ReAct 型の「思考→行動→観察」ループに6つのツールを持たせました。

    list_files / read_file で構造メタデータを辿ってから中身に踏み込む設計は PDFTriage と同じ発想。計算を LLM にさせず python へ委譲するのは PAL / PoT の直系です。view_page は M3DocRAG・ViDoRAG が示した「曖昧なときはページを直接見る」能力の実装で、キャプション索引(安価・網羅)とページ直接参照(高精度・オンデマンド)の二段構えになっています。

    日本語パス照合の落とし穴は、(1) NFC→実パスのマップを起動時に構築、(2) python ツールに正規化差異を吸収する find("キーワード", suffix=".csv") ヘルパーを注入、の2段でシステム側に吸収しました。エージェントが生成するコードも必ず踏む罠だからです。

    2-4. 検証ゲート — 「出す前に、根拠と突き合わせる」

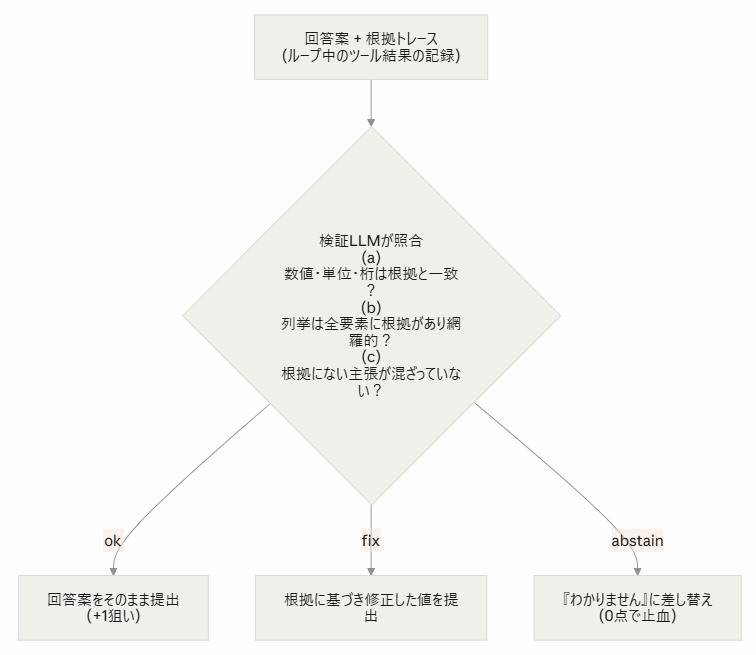
    最重要の安全弁が final 直前の根拠ゲート付き検証です。ループ中に蓄積した「根拠トレース」と回答案を照合する検証 LLM を1回だけ呼び、採点の非対称性(誤答-1/棄権0)を明示したうえで判定させます。

    生成後に自己批評・修正を挟む設計は Self-RAG 、Corrective RAG 、CRAG-MM 上位解の検証中心アーキテクチャに連なります。特に列挙問題(部分一致=-1)への「1要素でも怪しければ棄権」は、期待値上もっとも効く場所に置いた安全弁です。後述のローカル 7B 構成では、モデルが弱くなるほどこのゲートの価値が上がります。誤答 -1 を量産する代わりに棄権 0 で守れるためです。

    3. マルチエージェントや FastMCP は使うべきか

    設計中に検討し、どちらも採用しませんでした。判断基準は一つ、「その仕組みがこの採点仕様で期待スコアを上げるか」です。

    FastMCP はツールをプロセス外のクライアントに公開する仕組みですが、本コンペの実行モデルは「predictions.csv を作る単一プロセスを審査側が再現できること」で、公開する相手がいません。挟むと通信・サーバ起動・スキーマ層が増え、再現性を損ない障害点が増えるだけ。これは「運用化フェーズ」の選択肢です。

    マルチエージェントの利点(コンテキスト分離・並列化) は、本件では別手段で達成済みでした。案件ごとの情報分離は search(folders=[...]) のフォルダ絞り込みで、集計の正確性は pandas への委譲で担保。むしろエージェントを増やすと出力のばらつき・伝言ゲームの劣化・再現性低下・呼び出し数の増加を招きます。誤答 -1 を避けたいタスクでは「単一の統制されたループが、根拠を確かめてから、怪しければ棄権する」ほうが期待値が高く、CRAG 系上位解 も制御性重視の比較的単純な構成でした。

    4. 実装 — 2つの実行経路(API版/完全ローカル版)

    本体は単一の rag_pipeline.py(約1,500行)で、LLM 呼び出しを1つのクラスに集約してあります。そのため実行経路は設定1つで切り替えられます。

    4-1. API 版(OpenAI)

    OPENAI_API_KEY を設定し、Colab または任意の Python 環境で「Drive マウント → ZIP 展開 → パス確定 → インデックス構築 → 検証30問 → 本番100問 → zip」の順に実行します。残高切れ(429 insufficient_quota)は専用例外として検知し、インデックス構築・回答生成のどちらでもそこまでの成果を保存して中断→残高補充後に同じセルを再実行すれば差分から再開されます。構築前には estimate_index_cost() でファイル数・画像数(=API 呼び出し回数の目安)を課金なしで確認できます。

    4-2. 完全ローカル版(APIキーが発行できない場合)

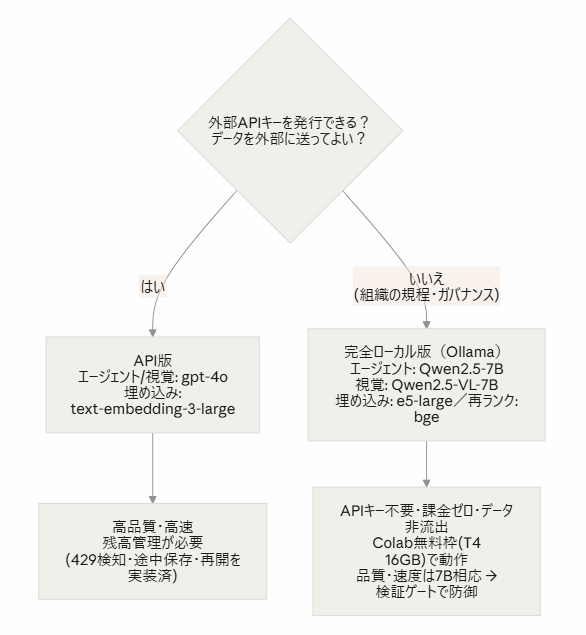
    組織の規程で外部 API キーを発行できない——今回まさにこの制約に直面しました。コンペ規約は「商用API、ローカルLLM、…を自由に利用できます」「使用可能なツールは、商業利用が可能でオープンなものに限定」と明記しており、オープンウェイトモデルのローカル実行は規約が名指しで認める王道です。

    役割モデルライセンス補足
    エージェント本体Qwen2.5-7B-Instruct(Ollama, 4bit量子化)Apache 2.0JSON モードで ReAct を安定化
    画像・グラフ読解Qwen2.5-VL-7BApache 2.0文書 OCR 系 OSS の定番土台
    埋め込みmultilingual-e5-largeMITGPU でローカル計算
    再ランクbge-reranker-v2-m3Apache 2.0もともとローカル

    すべて Colab 無料枠(T4 16GB)の VM 内で完結し、データは一切外に出ません。ローカル小型モデルは出力に前置きを混ぜて JSON を崩しがちなので、寛容 JSON パーサ(「まず検索します。{…}」のような出力から JSON 部分を救済)も入れました。再現性は API より強く、モデル重み固定+seed 固定で完全に同じ出力を再現できます。

    正直なトレードオフも書いておきます。7B は gpt-4o クラスより品質が落ちます(計算コード生成の粗さ・グラフ数値読解の精度)。目安時間はインデックス構築1〜3時間、検証30問1〜2時間、本番100問4〜8時間。この前提で、全工程を「1問ごとに Drive へ進捗保存 → 切断されても再実行で続きから」のレジューム設計にしました。無料枠のセッション切断は「起きるもの」として設計に織り込むのが正解です。

    5. 現場で踏んだ罠と、その一般化

    設計どおりに書いて終わり、にはなりませんでした。重要なのは、遭遇した問題を「このファイル・この環境だけの応急処置」ではなく「同じ性質を持つ未知の状況にも効く一般規則」として実装し直すことです。汎用性が検収要件そのものだからです。

    罠1: API 残高切れ(429 insufficient_quota)が大量発生。 画像 OCR のたびに弾かれ、放置するとグラフ・書式の情報が全部欠けたインデックスができてしまう。→ 一般規則: 回復不能なエラーは専用例外として検知し、途中保存して中断、再実行で差分再開。一時的エラー(500等)のリトライとは明確に区別する。

    罠2: 組織で API キーを発行できない。 → 一般規則: モデル依存を1クラスに集約しておけば、バックエンド追加(Ollama)だけで全機能がローカルへ移行できる。埋め込みは最初からローカルフォールバックを用意しておく。

    罠3: Ollama インストーラが zstd を要求して失敗(Colab 標準環境に未導入。インストーラ側の配布形式変更が原因)。→ 一般規則: 実行環境の前提は変わるもの。セットアップは冪等な「復旧セル」(本体確認→再インストール→サーバ起動→モデル確認→不足分 pull)として1つにまとめ、セッション切断後はそれ1つで戻れるようにする。

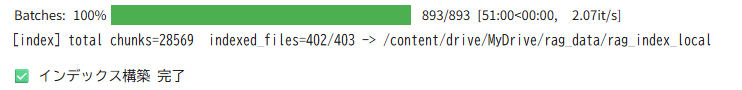
    ※OllamaのRAG作成には1時間近くかかった。

    罠4: ローカル VLM への画像送信が 400 Bad Request。 原因は Office 埋め込み画像に多い WMF/EMF 形式(Windows メタファイル)を VLM が受け付けないこと。→ 一般規則: VLM へ渡す前に PIL で PNG へ統一変換・長辺縮小。デコード不能な装飾画像は恒久スキップ、読めたはずの画像で失敗したファイルは manifest 除外で次回リトライ。エラーメッセージにはレスポンス本文を含めて原因を特定可能にする。

    罠5: パスワードそのものはどこにも書かれていない暗号化ファイル。 社内規定には「導出規則」だけがある。→ 一般規則: 規則文書を実行時に読み、LLM に機械適用させて候補を生成(前掲⑤)。規則の中身をコードに書かないので新規案件にも一般化される。

    罠6: 日本語ファイル名の NFC/NFD ゆれ。 → 一般規則: 正規化を1箇所(パス解決マップと find ヘルパー)に集約し、エージェント生成コードにも同じヘルパーを使わせる。

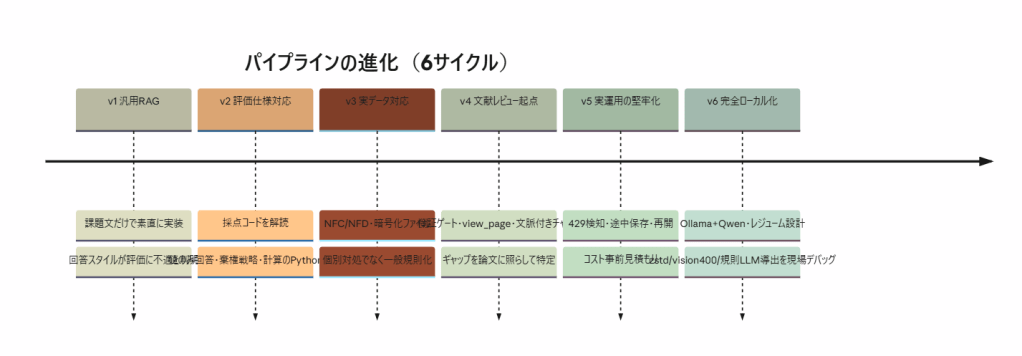
    6. PDCA — 6サイクルの反復

    各サイクルの Act が次の Plan になっています。特に v4 は「自分の実装を先行研究に照らして棚卸しする」回で、(a) 検証ゲート未実装、(b) ページ直接参照 の欠落、(c) チャンク文脈付与 未適用、の3ギャップを特定して埋めました。文献レビュー自体を Check 工程に組み込むと、改善の打ち手が経験則ではなく再現された知見から出せます。v6 は「環境が理想でなくても動かし切る」回で、罠1〜5 の一般規則化がここに入ります。

    次のサイクルは精度チューニングです。検証30問(正解つき)をローカル採点し、誤答の型(検索ミス/計算ミス/形式ズレ/棄権すべきだった誤答)を分類 → パラメータとプロンプトを調整 → 再計測。「特定の質問に合わせた調整」はルール違反なので、誤答の”型”への一般的な改善だけを行うのが鉄則です。

    7. 工夫すべきポイント(まとめ)

    評価器を最初に読む。 最大のレバレッジは「採点 LLM が質問文を見ない」「列挙の部分一致は -1」「Missing は 0」の把握でした。CRAG [1] が示すとおり最先端の産業 RAG でもハルシネーションなしは6割程度。何を正解とするかを先に固定するのは実務でも同じです。

    期待値で棄権を設計し、検証ゲートで守る。 誤答-1/棄権0 の非対称性がある以上「自信のない列挙は答えない」は合理的で、KDD Cup 上位解 の定石。生成→検証→棄権を最後に1段入れるだけで、最も高くつく失敗を系統的に減らせます。モデルが小さいほど効きます。

    LLM に算術をさせない。 集計・件数・平均・差分は必ずコード実行に落とす(PAL / PoT)。pandas を渡すだけで計算問題の信頼性が桁違いに上がります。

    パースを軽視しない。 OCR・抽出のノイズは下流で増幅される(OHRBench)。形式ごとに最も正確な読み方を選び、キャプション索引+ページ直接参照 で視覚情報を拾う。VLM へ渡す画像は形式・サイズを正規化してから。

    チャンクに文脈を前置する。 《案件|ファイル名|位置》の機械的前置だけでも検索が安定します(Contextual Retrieval の軽量版)。

    順位ベースの融合(RRF)を使う。 学習不要・校正不要でコーパス規模の変化に強い。汎用性要件と相性が良い。

    増分性と再開性を同じ仕組みで。 台帳の「失敗は載せない=次回リトライ」という1規則が、データ追加・中断再開・部分失敗のすべてを賄います。加えて回答側も1問ごと進捗保存にすれば、セッション切断が怖くなくなります。

    道具立てはスコアで選ぶ。 マルチエージェントや MCP は「使えるから使う」ではなく「この採点でスコアを上げるか」で判断。今回はどちらも見送りが正解でした。

    環境の罠も一般規則で潰す。 依存の変化(zstd)、形式の癖(WMF/EMF)、規程の制約(APIキー不可)——すべて「次も起きる」前提で、冪等な復旧手順・正規化層・バックエンド抽象化として実装に落とす。

    8. 実装環境まとめ

    • 開発・検証: Ubuntu 24 / Python 3.12。LLM・埋め込みをモックにしてネットワークなしで結合テスト(モック Ollama サーバを立て、実 HTTP 経路まで検証)
    • API 版: 任意の Python 3.10+ 環境。OPENAI_API_KEY と残高が必要。gpt-4o + text-embedding-3-large
    • ローカル版: Google Colab 無料枠(T4 GPU 16GB)で動作。Ollama + Qwen2.5-7B / Qwen2.5-VL-7B + e5-large + bge-reranker。APIキー・課金・外部送信なし
    • 評価: 配布のローカル評価環境で提出前にスコアを見積もり可能。検証30問(正解つき)→ 本番100問の順で回すのが安全
    • 規模感: 約400ファイル(docx/pptx/xlsx/pdf/ipynb/py/png等)から約1.2万チャンク。コード本体は単一ファイル約1,500行

    9. 今後の拡張候補(文献ベースの伸びしろ)

    意図的に採らなかった選択肢のうち、要件が変われば有力になるもの。ページ画像を直接インデックスする ColPali 系検索 は、スキャン中心・レイアウト依存の強いコーパスなら乗り換える価値があります。案件間・人物間の関係を問う質問が増えるなら GraphRAG や階層要約木の RAPTOR。巨大帳票が主戦場なら SpreadsheetLLM のシート圧縮。xlsx のセル塗り色・文字ハイライトの構造抽出(openpyxl の fill 情報等)は、書式を問う質問への次の一手です。常設ツール化するなら MCP でのサーバ公開。文書中心マルチモーダル RAG の全体像はサーベイ が出発点です。

    参考文献

    [1] Yang, X. et al. “CRAG — Comprehensive RAG Benchmark.” arXiv:2406.04744 (2024). [2] Xia, Y., Chen, J., Gao, J. “Winning Solution For Meta KDD Cup’24.” arXiv:2410.00005 (2024). [3] Ouyang, J. et al. “Revisiting the Solution of Meta KDD Cup 2024: CRAG.” arXiv:2409.15337 (2024). [4] “Multi-Stage Verification-Centric Framework for Mitigating Hallucination in Multi-Modal RAG”(KDD Cup 2025 CRAG-MM). arXiv:2507.20136 (2025). [5] Yao, S. et al. “ReAct: Synergizing Reasoning and Acting in Language Models.” arXiv:2210.03629 (2022). [6] Singh, A. et al. “Agentic Retrieval-Augmented Generation: A Survey on Agentic RAG.” arXiv:2501.09136 (2025). [7] Liang, J. et al. “Reasoning RAG via System 1 or System 2: A Survey on Reasoning Agentic RAG for Industry Challenges.” arXiv:2506.10408 (2025). [8] Gao, L. et al. “PAL: Program-aided Language Models.” arXiv:2211.10435 (2022). [9] Chen, W. et al. “Program of Thoughts Prompting.” arXiv:2211.12588 (2022). [10] Faysse, M. et al. “ColPali: Efficient Document Retrieval with Vision Language Models.” arXiv:2407.01449, ICLR 2025. [11] Yu, S. et al. “VisRAG: Vision-based Retrieval-augmented Generation on Multi-modality Documents.” arXiv:2410.10594, ICLR 2025. [12] Cho, J. et al. “M3DocRAG: Multi-modal Retrieval is What You Need for Multi-page Multi-document Understanding.” arXiv:2411.04952 (2024). [13] Wang, Q. et al. “ViDoRAG: Visual Document Retrieval-Augmented Generation via Dynamic Iterative Reasoning Agents.” arXiv:2502.18017, EMNLP 2025. [14] Zhang, J. et al. “OCR Hinders RAG: Evaluating the Cascading Impact of OCR on Retrieval-Augmented Generation.” arXiv:2412.02592, ICCV 2025. [15] “SERVAL” — VLM生成キャプションをテキストエンコーダで索引する generate-then-encode 方式 (2025). [16] Poznanski, J. et al. “olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models.” arXiv:2502.18443 (2025). [17] Niu, J. et al. “MinerU2.5: A Decoupled Vision-Language Model for Efficient High-Resolution Document Parsing.” arXiv:2509.22186 (2025). [18] Ouyang, L. et al. “OmniDocBench: Benchmarking Diverse PDF Document Parsing with Comprehensive Annotations.” arXiv:2412.07626, CVPR 2025. [19] Dong, H. et al. “SpreadsheetLLM: Encoding Spreadsheets for Large Language Models.” arXiv:2407.09025 (2024). [20] Anthropic. “Introducing Contextual Retrieval.” Engineering blog (2024). [21] Cormack, G., Clarke, C., Buettcher, S. “Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods.” SIGIR 2009. [22] Asai, A. et al. “Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection.” arXiv:2310.11511 (2023). [23] Yan, S. et al. “Corrective Retrieval Augmented Generation.” arXiv:2401.15884 (2024). [24] Saad-Falcon, J. et al. “PDFTriage: Question Answering over Long, Structured Documents.” arXiv:2309.08872, EMNLP 2024 Industry. [25] “Scaling Beyond Context: A Survey of Multimodal RAG for Document Understanding.” arXiv:2510.15253 (2025). [26] Edge, D. et al. “From Local to Global: A Graph RAG Approach to Query-Focused Summarization.” arXiv:2404.16130 (2024). [27] Sarthi, P. et al. “RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval.” arXiv:2401.18059 (2024).

  • この記事でわかること

    • Ollama とは何か、なぜ注目されているのか
    • クラウドLLM(ChatGPT / Claude / Gemini など)と比べた メリット・デメリット
    • Ollama が どういう仕組み(アーキテクチャ) で動いているか(ネットワーク構成込み)
    • macOS / Windows / Linux での 導入手順(画面キャプチャつき)
    • 使う上での セキュリティ上の注意点

    1. Ollama とは
    Ollama(オラマ) は、大規模言語モデル(LLM)を 自分のPC上でローカルに動かす ためのオープンソースツールです(MITライセンス、Go 言語製)。よく「LLM 版の Docker」と表現されます。docker run のように ollama run <モデル名> と打つだけで、モデルのダウンロードから起動、対話までを一気にやってくれるからです。

    ollama run llama3.1:8b

    これ一行で、Meta の Llama 3.1(8B)が手元のマシンにダウンロードされ、その場でチャットが始まります。クラウドにも API キーにも一切つながず、インターネットが切れていても動く のが最大の特徴です。

    利用できるモデルは Llama、Gemma、Qwen、DeepSeek、Phi、Mistral、gpt-oss、埋め込み用の nomic-embed-text など多岐にわたり、公式の ollama.com/library から探せます(ラインナップは頻繁に更新されるので、最新は公式ライブラリを確認してください)。


    2. クラウドLLM との比較 ― どちらを選ぶべきか

    まず結論を表で示します。

    観点Ollama(ローカルLLM)クラウドLLM(ChatGPT / Claude / Gemini など)
    料金体系初期のハードウェア費用のみ。推論は何回やっても無料(電気代を除く)トークン単位の従量課金。使うほどコストが増える
    プライバシー入力データが マシンの外に出ない。第三者に送信されない入力が事業者のサーバーに送信される(規約次第で学習・保持の可能性)
    オフライン動作◎ ダウンロード後は 完全オフラインで動作× 常時インターネット接続が必須
    法規制・コンプラ対応院内・行内・機密環境など データを外に出せない現場 で採用しやすいデータ越境が問題になるケースがある(GDPR / 医療情報 等)
    モデルの絶対性能ハードウェア次第。オープンモデルは大幅に進化したが、最難関タスクはクラウドが優位◎ 常に 最先端(フロンティア)モデル を利用できる
    必要なハードウェアGPU / 大容量メモリがあると快適(CPU のみでも動作可)◎ 不要。手元は非力でもよい
    カスタマイズ性◎ モデル・パラメータ・システムプロンプトを Modelfile で完全制御△ API の範囲内に限定される
    スケール(同時多数)少人数向き。大量同時アクセスは苦手◎ 事業者側で自動スケール
    運用・保守自分で管理(更新・監視・バックアップ)◎ フルマネージド

    2-1. コスト ― 従量課金 vs 固定費

    クラウドLLMは 入力・出力トークンごとの課金 です。個人利用なら安価でも、社内ツールやバッチ処理で 大量のリクエストを回すと料金が跳ね上がります。

    Ollama は逆で、モデルを動かすハードウェアさえ用意すれば、その後の推論は何回実行しても追加料金ゼロ。「同じ処理を毎日大量に回す」「開発中に何百回も試行錯誤する」といった使い方では、ローカル実行のコスト優位が効いてきます。

    2-2. プライバシーとセキュリティ ― “外に出ない” という価値

    Ollama の推論は すべて手元のマシンで完結 します。入力したプロンプト・社内文書・ソースコード・個人情報が、外部のサーバーに送られることはありません。

    • 医療・法務・金融など、機密データを外部に出せない現場
    • 未公開の製品情報やソースコードを扱う 開発現場
    • 顧客情報を含む文書の要約・分類

    こうしたユースケースでは、「データが外に出ない」こと自体が、クラウドでは代替しにくい価値になります。

    2-3. どちらを選ぶ? ― 使い分けの指針

    • クラウドLLMが向く:最高難度の推論、最新モデルをすぐ使いたい、手元にGPUがない、少ない手間で始めたい、大量同時アクセスをさばきたい。
    • Ollama が向く:機密データを扱う、オフライン環境で使う、大量リクエストを低コストで回す、モデルを細かく制御・実験したい、ネット接続に依存したくない。

    実務では「日常の下書きや軽い分類はローカル、難しい仕上げだけクラウド」というハイブリッド運用も有力です。


    3. Ollama が向かない・注意すべきケース(デメリット)

    公平のために、Ollama が万能ではない点も挙げます。

    • 最先端モデルの絶対性能では、依然クラウドが優位。ローカルで動く量子化モデルは軽快ですが、最難関のタスクではフロンティアモデルに一歩譲る場面があります。
    • 大量同時アクセス・高スループット本番運用には不向き。多人数へ同時提供する本番APIや、最大スループットが要るバッチ処理では、vLLM や TGI のような専用サーバーが適しています。Ollama は「個人〜小チームの手元実行」に最適化されています。
    • 相応のハードウェアが要る。大きいモデルほど GPU の VRAM やメインメモリを消費します(後述の目安を参照)。
    • 運用は自己責任。モデル更新、監視、バックアップ、そして後述の ネットワーク公開時のセキュリティ は自分で面倒を見る必要があります。

    4. 動作の仕組み(ネットワーク構成込みアーキテクチャ)

    Ollama は クライアント/サーバー型 で動きます。全体像は次の図のとおりです。

    Ollama のネットワーク構成込みアーキテクチャ図

    図:Ollama アーキテクチャ(ネットワーク構成込み)。編集可能な draw.io ソース ollama-architecture.drawio を同梱しています。

    4-1. 処理の流れ

    1. ① クライアント:ollama CLI、各言語のSDK、Open WebUI のようなチャットUI、IDE拡張(Continue / Cursor)、curl や自作アプリなどが、HTTPリクエスト(REST API) を送ります。
    2. ② Ollama サーバー(デーモン):ollama serve が常駐し、127.0.0.1:11434 で待ち受けます。ここには次の層があります。
      • HTTP API 層(内部で web フレームワークと CORS 制御)
      • OpenAI 互換 / Anthropic 互換ミドルウェア … 既存のSDKを エンドポイントのURLを差し替えるだけ でそのまま使えます
      • ルートハンドラ(Chat / Generate / Embed / Pull / Push / Create)
      • スケジューラ → メモリマネージャ … モデルをどこ(VRAM か RAM か)にどれだけ載せるかを判断し、GPUに乗り切らない層は自動的にCPU側に振り分け(レイヤーオフロード) ます
    3. ③ llama.cpp ランナー:実際の推論を担う C++ 製の推論エンジン。CPU・Apple Metal・NVIDIA CUDA・AMD ROCm に対応します。
    4. ④ ハードウェア:GPU / CPU / メモリ。GPUがあれば自動検出して高速化します。
    5. ⑤ モデルストレージ:ダウンロード済みモデルは ~/.ollama/models に GGUF 形式(量子化済みの blobs) と manifest として保存されます。推論時はここから重みを読み込みます。

    4-2. ネットワーク面のポイント(ここが重要)

    • 待受は既定でループバック(127.0.0.1)。つまり 既定では同じマシンからしかアクセスできず、外部ネットワークからは到達できません。
    • 外部との通信が発生するのは「モデル取得(ollama pull)」のときだけ。公式レジストリ(ollama.com/library、Docker Hub のような配布元)からモデルをダウンロードします。一度落とせば、あとはオフラインで動作 します。
    • 推論データは外に出ません。プロンプトも文書も生成結果も、すべてマシン内で完結します(=プライバシー保護・オフライン動作の根拠)。
    • LANの他端末から使いたい場合 は、環境変数 OLLAMA_HOST=0.0.0.0:11434 で待受を開放できますが、Ollama は既定で認証を持ちません。開放する場合は ファイアウォールやリバースプロキシ(認証付き)で必ず保護 してください(詳細は §7)。

    5. 導入手順(キャプチャつき)

    キャプチャについての注記:以下のうち ターミナル画面はコマンドの実挙動を再現 したものです。ダウンロードページやアプリ常駐アイコンの図は 実画面に近い再現イメージ で、レイアウトはOSやバージョンで多少異なります。ご自身の環境で公開・共有する際は、実際の画面に差し替えてご利用ください。

    5-0. 動作環境と必要スペックの目安

    メモリ / GPU の目安快適に動くモデルの目安用途イメージ
    RAM 8GB(GPUなし可)1B〜3B(Llama 3.2、Gemma 3 4B 等)軽い要約・分類・下書き
    RAM 16GB + 専用GPU7B〜14B(“ちょうど良い”帯)日常の実用タスク全般
    RAM 32GB+ / VRAM 24GB+70B クラス難しめの推論・長文処理

    目安として、4bit量子化(Q4_K_M 等)で 10億パラメータあたり約0.6〜0.7GB のメモリを見込みます(8Bなら概ね5〜6GB前後)。GPUがなくても CPUのみで動作 しますが、速度は数倍遅くなります。

    5-1.【macOS / Windows】公式サイトからダウンロード

    ブラウザで ollama.com/download を開き、OSタブ(macOS / Windows / Linux)を選んで ダウンロードボタン を押します。

    Ollama ダウンロードページ(再現イメージ)

    図:ダウンロードページ。OSタブを切り替えると各OS向けの入手方法が表示されます(再現イメージ)。

    ダウンロードしたインストーラーを実行し、画面の指示に従ってインストールします(macOS はアプリを「アプリケーション」へドラッグ、Windows はインストーラーを実行するだけ)。

    5-2.【macOS / Windows】起動している状態を確認

    インストールすると Ollama は バックグラウンドのデーモンとして自動起動 します。起動中は、macOS はメニューバー右上、Windows はタスクトレイ(右下) に Ollama のアイコンが常駐します。

    macOS メニューバー / Windows タスクトレイでの常駐表示(再現イメージ)

    図:起動中はアイコンが常駐します(左:macOS、右:Windows。再現イメージ)。

    5-3.【Linux】ワンライナーでインストール

    Linux は公式のインストールスクリプトが手軽です。ターミナルで次を実行します。

    curl -fsSL https://ollama.com/install.sh | sh

    スクリプトが依存関係の導入、ollama ユーザーの作成、systemd サービスの登録・起動 までを行い、最後に API が 127.0.0.1:11434 で利用可能 になった旨が表示されます。NVIDIA GPU があれば自動検出されます。

    Linux でのインストール実行画面

    図:curl … | sh の実行結果。systemd サービスとして起動し、11434 ポートで待受を開始します。

    ※ パイプ実行に抵抗がある場合は、スクリプトを一度ダウンロードして中身を確認してから実行しても構いません。

    5-4. インストールの確認

    OS共通で、バージョン表示とローカルAPIの疎通を確認します。

    ollama --version
    curl http://localhost:11434/api/version
    curl http://localhost:11434 # → Ollama is running
    バージョンとAPI疎通の確認画面

    図:ollama --version と 127.0.0.1:11434 への疎通確認。Ollama is running が返れば正常です。

    5-5. 初めてのモデル実行

    いよいよモデルを動かします。ollama run は、モデルが未取得なら 自動でダウンロードしてから 対話モードに入ります。

    ollama run llama3.1:8b

    ダウンロード完了後、>>> プロンプトが出たら日本語でそのまま話しかけられます。入力内容は一切外部に送信されません。 対話を終えるときは /bye と入力します。

    初回実行(ダウンロード → 日本語対話)の画面

    図:初回は自動でモデルを取得し、そのまま対話に入ります。日本語での応答も問題ありません。

    5-6. モデルの管理

    取得済みモデルの一覧や、いまメモリに載っているモデルは次のコマンドで確認できます。

    ollama list # 取得済みモデル一覧
    ollama ps # メモリにロード中のモデル
    ollama pull qwen3:14b # モデルだけ先に取得
    ollama rm gemma3:4b # モデルを削除
    モデル一覧とロード状況の確認画面

    図:ollama list で取得済み一覧、ollama ps で現在ロード中のモデルとGPU使用状況を確認できます。

    5-7. REST API から使う(アプリ組み込み)

    Ollama はローカルにREST APIを立てているので、自作アプリやスクリプトから直接叩けます。ネイティブAPI(/api/chat)に加え、OpenAI互換エンドポイント(/v1/chat/completions) も用意されているため、既存のOpenAI向けSDKは接続先URLを差し替えるだけ で流用できます。

    curl による API 呼び出し(ネイティブ / OpenAI互換)

    図:/api/chat(ネイティブ)と /v1/chat/completions(OpenAI互換)の両方が使えます。

    Python から使う例(OpenAI互換):

    from openai import OpenAI
    client = OpenAI(
    base_url="http://localhost:11434/v1", # ← ここをローカルに向けるだけ
    api_key="ollama", # 任意の文字列でOK(既定は認証なし)
    )
    resp = client.chat.completions.create(
    model="llama3.1:8b",
    messages=[{"role": "user", "content": "自己紹介して"}],
    )
    print(resp.choices[0].message.content)

    5-8. (おまけ)ブラウザUIで使いたいなら

    CLIではなくブラウザのチャット画面で使いたい場合は、Open WebUI などのフロントエンドを Ollama(11434)に接続すると、ChatGPT風のUIでローカルモデルを扱えます。


    6. よく使うコマンド早見表

    コマンド説明
    ollama run <model>モデルを(必要ならDLして)実行・対話
    ollama pull <model>モデルの取得のみ
    ollama list取得済みモデル一覧
    ollama psメモリにロード中のモデル
    ollama rm <model>モデルを削除
    ollama serveサーバー(デーモン)を手動起動
    ollama create -f Modelfile <name>Modelfile から独自モデルを作成
    ollama show <model>モデルの詳細・パラメータ表示

    7. セキュリティ上の注意点(重要)

    • 既定はローカル専用・認証なし:127.0.0.1:11434 で待ち受け、認証はありません。同じマシン内だけで使う分には外部から到達できず安全です。
    • LAN / インターネットへ公開するときは要注意:OLLAMA_HOST=0.0.0.0 などで待受を開放すると、認証なしのまま外部からアクセス可能 になってしまいます。実際に、設定を誤って公開されたOllamaサーバーが第三者に無断利用される事例も報告されています。公開が必要な場合は、
      • ファイアウォールで接続元を制限 する、
      • 認証付きのリバースプロキシ(Nginx / Caddy 等)を前段に置く、
      • VPN や SSH ポートフォワード経由に限定する、 といった対策を 必ず 併用してください。
    • モデルの入手元に注意:モデルは信頼できる公式ライブラリから取得しましょう。

    8. まとめ

    Ollama は、LLMを自分のマシンで手軽に動かすための決定版ツールです。クラウドLLMと比べたときの核心は次の3点に集約されます。

    1. プライバシー:データが外に出ない。
    2. コスト:ハードウェアさえあれば推論は使い放題(従量課金なし)。
    3. オフライン & 制御:ネット不要で動き、モデルを細かく制御・実験できる。

    一方で、最先端の絶対性能や大規模同時アクセス はクラウド/専用サーバーに分があります。両者は排他ではなく、「軽い・機密・大量はローカル、難しい仕上げはクラウド」 と使い分けるのが賢い付き合い方です。

    まずは ollama run llama3.1:8b の一行から、ローカルLLMの世界を体験してみてください。


    本記事の図版のうち、アーキテクチャ図は同梱の ollama-architecture.drawio を draw.io(diagrams.net) で開くと自由に編集できます。ターミナル画面はコマンドの実挙動を、GUI画面は実画面に近い再現イメージを示しています。公開時はご自身の環境のスクリーンショットへの差し替えを推奨します。

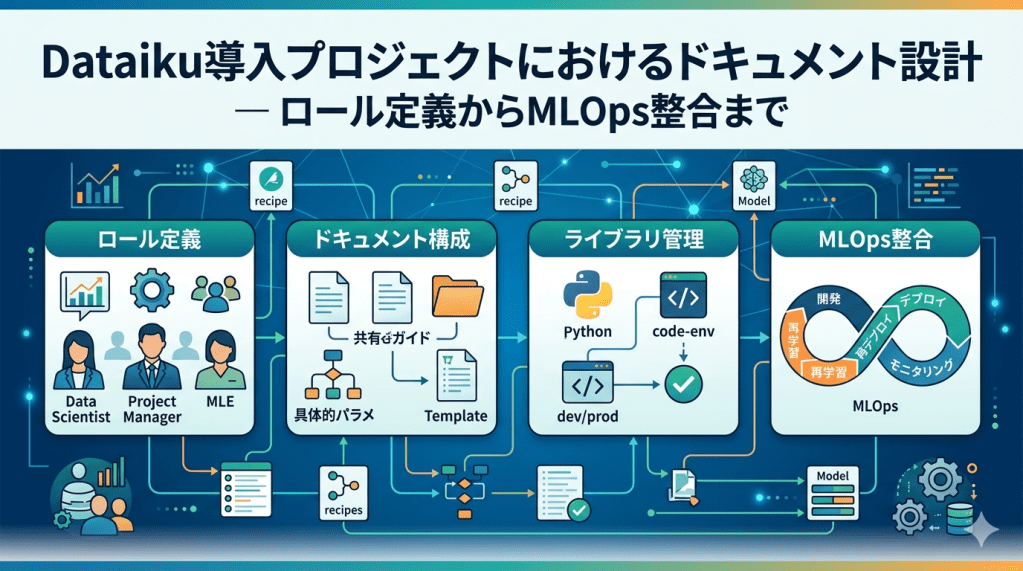
  • Dataiku導入プロジェクトにおけるドキュメント設計 ― ロール定義からMLOps整合まで


    「手順書を作って」から始まる問題

    Dataikuを導入した企業の新規プロジェクトで、実装が現実的になった段階で、

    「ユーザー向け手順書の作成をお願いします。」

    という依頼を受けたことがある。

    何が問題になったかというと、「誰向けの、何のための手順書か」が決まっていないことで、作成したものが使われずらいもので、修正依頼が多々来たことである。

    Dataikuはノーコード分析からPythonベースのモデル開発、API Deployer、シナリオによるパイプライン自動化まで守備範囲が広い。ロールごとの利用シーンを洗い出すと、手順書の数はどんどん増えていく。何も考えずに書き始めると、似たような内容のドキュメントが乱立し、作成や更新に時間的コストがかかってしまう。

    本稿では、実際のDataiku導入プロジェクトで行ったドキュメント設計のプロセスを共有する。ロールの定義、統合・分離の判断基準、dev/prod環境のライブラリ管理、そしてMLOpsサイクルとの対応関係まで整理した。


    1. まず「誰がDataikuを使うのか」を決める

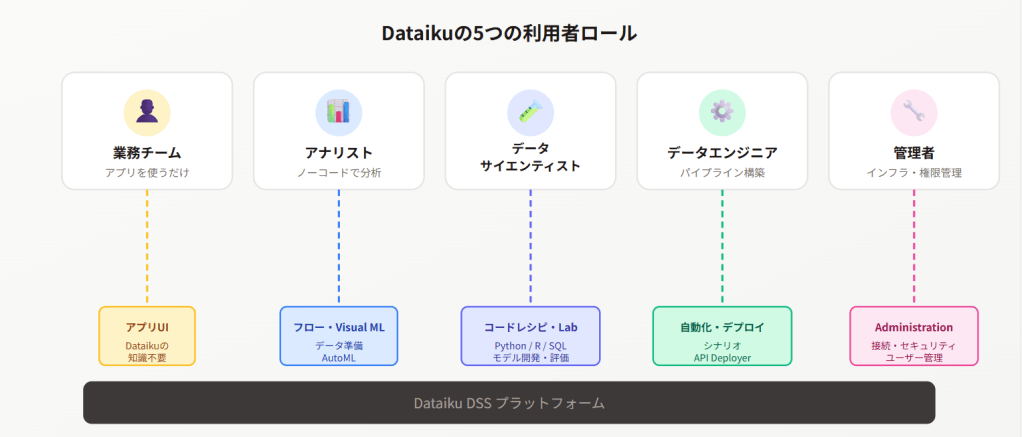
    手順書を書き始める前に、利用者を分類する。我々のプロジェクトでは5つのロールを置いた。

    ロール概要Dataikuの利用レイヤー
    業務チームDataikuアプリのエンドユーザー。プラットフォームの知識はゼロアプリUI
    アナリストノーコードでデータ準備・Visual MLを活用フロー・Visual ML
    データサイエンティストPython/R/SQLによるモデル開発・評価コードレシピ・Notebook・Lab
    データエンジニアパイプライン構築・シナリオ・API Deployer運用自動化・デプロイ
    管理者インフラ・接続・権限管理Administration

    ポイントは、Dataikuユーザーとなる業務チームの扱いだ。彼らにとって「フロー」「レシピ」「シナリオ」は全て、専門用語となる。

    そのため、業務チーム向けのドキュメントにはDataikuという単語を出さない。「分析ツール」「○○システム」など、業務の文脈に合った名前で統一する。将来プラットフォームを乗り換えることになっても、業務チーム側のドキュメント改修が少なくて済む。


    2. 「まとめるもの」と「分けるもの」の線引き

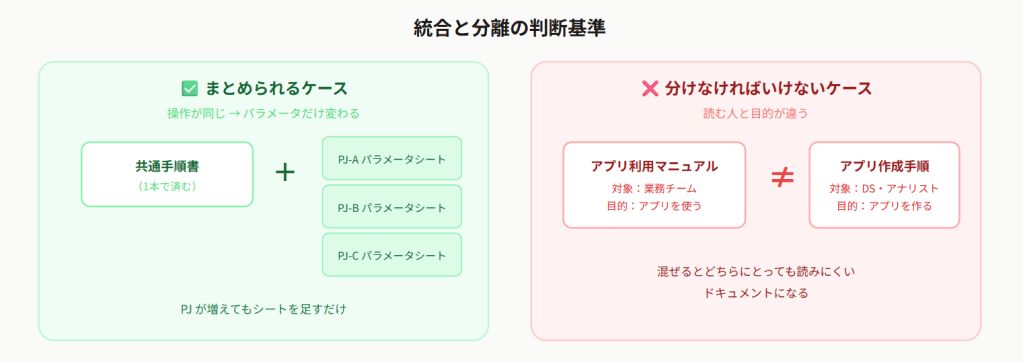
    ロールを決めたら、次は統合と分離の判断基準を定める。

    まとめられるケース

    操作の流れが共通で、変わるのがプロジェクト固有のパラメータだけなら、1本にまとめてよい。

    たとえばフロー操作やレシピ作成の手順は、プロジェクトが変わってもやることは同じである。違うのはデータセット名やモデル名、接続先くらいなので、こういう構成にする。

    共通手順書(1本) + プロジェクト別パラメータシート(テンプレート)

    プロジェクトが増えてもパラメータシートを埋めるだけで回せるので、複数プロジェクトを並行する現場ほど楽になる。

    分けなければいけないケース

    読む人と目的が違うドキュメントは、分ける。 わかりやすいのがアプリの「作成」と「利用」である。

    ドキュメント対象者目的
    アプリ利用マニュアル業務チームアプリを使う
    アプリ作成手順(開発標準手順書に統合)アナリスト・DSアプリを作る

    読む人の技術レベルも関心も違う。一緒にすると、どちらにとっても読みにくいドキュメントになるため、分ける必要がある。


    3. dev/prod環境とPythonライブラリ管理

    Dataikuを本番運用するなら、開発環境(dev)と本番環境(prod)の分離は前提になる。ここで見落とされがちなのがコードenv・Pythonライブラリの管理だ。

    dev/prodそれぞれでコードenvを別々に管理する必要があり、これは複数のドキュメントにまたがる話になる。私たちはこの部分を専用の手順書として独立させた。理由は以下の3つ。

    • dev→prodへのライブラリ反映は、コードのデプロイとは別の手順があるため
    • prod環境への反映には承認フローが必要で、誰が承認するのかを書く場所が要るため
    • ライブラリの競合やバージョン不整合が起きたときの対処は、他の手順書と話の文脈が違うため

    後述するライフサイクルマッピングを見るとわかるが、この手順書は環境構築・開発・デプロイ・保守の4フェーズに横断する。一番早く整備しておくべきドキュメントであったようにも思われた。


    4. 手順書の最終構成

    ここまでの方針で整理した結果、以下の構成になった。

    共通手順書(9本)

    #手順書名対象ロール主な内容
    BFAQ・問い合わせガイド業務チームよくあるエラーと対処法 / エスカレーションフロー / 問い合わせ先
    Dモデル開発手順書アナリスト・DSVisual ML / 学習・評価・チューニング / Python・R・SQLレシピ / プラグイン導入
    G環境構築・初期設定手順書管理者DSSインストール / ライセンス適用 / データ接続設定 / dev・prod初期構築
    Hユーザー・権限管理手順書管理者ユーザーCRUD / グループ・ロール設定 / プロジェクト別権限 / dev・prod間の権限分離
    J保守・障害対応手順書管理者・エンジニアバックアップ・リストア / ログ解析 / バージョンアップ / 障害時エスカレーション
    Kオンボーディング・引き継ぎガイド全ロール役割別の初期アクション / プロジェクト引き継ぎ / ドキュメント規約 / 手順書ガイドマップ
    LDataiku 開発標準手順書アナリスト・DSプロジェクト作成 / フロー設計・命名規約 / レシピ操作 / アプリ作成・公開 / ダッシュボード
    MDataiku 運用標準手順書DS・エンジニアAPI Deployer / Batchデプロイ / dev→prod昇格 / シナリオ構築 / モデル監視・ドリフト検知
    Nコードenv・Pythonライブラリ管理手順書管理者・DSdev・prodコードenv作成 / ライブラリ追加・バージョン管理 / dev→prod反映 / 承認フロー / 競合対処

    プロジェクト固有手順書(アプリ数 × プロジェクト数分)

    #手順書名対象ロール主な内容
    Aアプリ利用マニュアル業務チームアクセス・ログイン / 画面説明 / 入力・実行操作 / 結果確認 / CSV・Excel出力

    プロジェクトごとに作成が必要なのは、このアプリ利用マニュアルだけで、それ以外は共通手順書+パラメータシートでカバーできている。

    テンプレート

    #名称用途主な内容
    Tプロジェクト別パラメータシートL・M・Nと組み合わせて使用プロジェクト名・概要 / データセット一覧 / モデル名・バージョン / APIエンドポイント / スケジュール設定 / 使用ライブラリ(dev・prod別) / 担当者

    5. ライフサイクルのどこで使うか

    手順書は作っただけでは棚に置かれて終わる。どのフェーズで誰が開くのかをはっきりさせておかないと、現場で参照されない。

    #手順書名環境構築開発テストデプロイ運用保守
    Aアプリ利用マニュアル✅
    BFAQ・問い合わせガイド✅
    Dモデル開発手順書✅✅
    G環境構築・初期設定手順書✅
    Hユーザー・権限管理手順書✅
    J保守・障害対応手順書✅
    Kオンボーディング・引き継ぎガイド✅
    LDataiku 開発標準手順書✅✅
    MDataiku 運用標準手順書✅✅
    Nコードenv・Pythonライブラリ管理手順書✅✅✅✅
    Tプロジェクト別パラメータシート✅✅✅

    こうして並べると、何から手をつけるべきかが見える。N(コードenv管理)は4フェーズにまたがっているので、最初に書いておくと後が楽だ。T(パラメータシート)はテンプレートを早めに固めておくと、開発からデプロイへの引き継ぎで手戻りが減る。


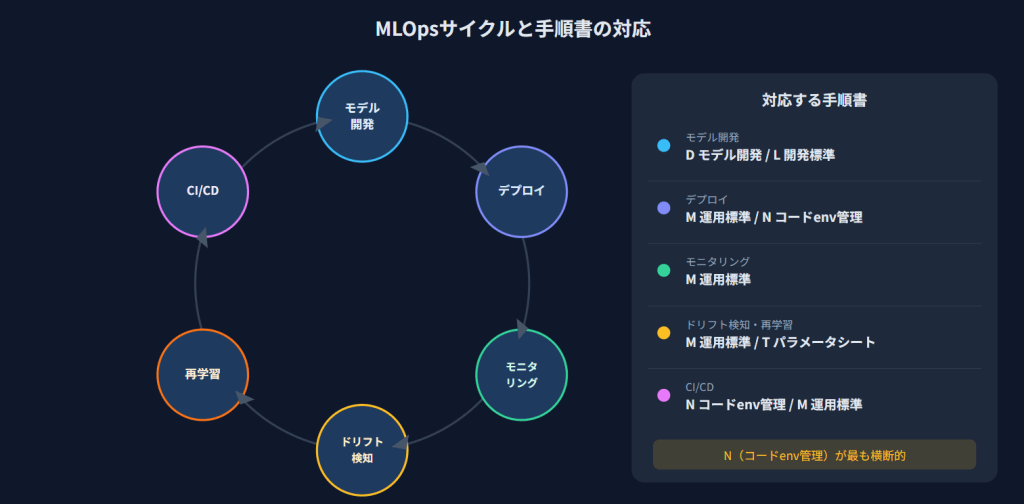
    6. MLOpsサイクルとの対応

    ここまでの手順書構成は、そのままMLOps(Machine Learning Operations)の運用基盤として使える。

    MLOpsとは、モデルの開発と運用を切り離さず、ひとつのサイクルとして回し続ける考え方だ。たとえば来客者数予測のように天候やイベントの影響を受けるモデルでは、一度作って終わりにはならない。

    モデル開発 → デプロイ → モニタリング → ドリフト検知 → 再学習 → 再デプロイ

    このサイクルの各ステップが、そのまま手順書に対応する。

    MLOpsサイクル対応する手順書やること
    モデル開発D(モデル開発), L(開発標準)特徴量設計・学習・評価・チューニング
    デプロイM(運用標準), N(コードenv管理)dev→prod昇格・API Deployer・ライブラリ反映
    モニタリングM(運用標準)ドリフト検知・精度指標の定期確認
    再学習トリガーM(運用標準), T(パラメータシート)閾値を超えたときの再トレーニング自動実行
    CI/CDN(コードenv管理), M(運用標準)モデルバージョニング・検証・自動デプロイ

    「どの手順書を、いつ、誰が見るか」が決まっていれば、MLOpsは特定の人に依存せず、チームの仕組みとして回る。ドキュメント設計は単なる文書管理ではなく、MLOpsを組織に根づかせるための土台でもある。


    まとめ

    Dataikuプロジェクトでドキュメントを設計するときに押さえておきたいポイントを以下に並べた。

    • 利用者を5ロールに分けてから設計する。 ロールが曖昧なまま書き始めると、誰向けかわからない手順書が量産されるため。
    • 業務チーム向けにはDataikuの用語は出さない。 彼らの関心はアプリの操作結果であって、プラットフォームの仕組みではないため。
    • 共通手順書+パラメータシートで標準化する。 プロジェクトが増えてもパラメータシートを足すだけで対応できるため。
    • 「作る手順書」と「使う手順書」は分ける。 読み手が違うものを1本にまとめると、どちらにとっても使いにくくなる。
    • Pythonライブラリ管理は独立した手順書にする。 dev/prodをまたぐ話は他の手順書と混ぜない。
    • ライフサイクルのどのフェーズで使うかを明示する。 「いつ開くか」がわからない手順書は読まれないため。
    • 手順書構成をMLOpsサイクルに対応させる。 ドキュメントの構造がそのまま運用の構造になる。

    設計の方針を持って整理すれば、手順書の本数もメンテナンスコストも抑えられる。

    これからDataikuを導入するチームにとって、何かしら参考になれば幸いです。

  • 【SIGNATEコンペ】(金融庁共催)第4回金融データ活用チャレンジ ~要件定義編~

    金融庁が主催する国際的なイベント「Japan Fintech Week 2026」。このイベントと連携した、非常に挑戦的なコンペティションが開催されます。

    テーマは、地域金融機関における取引先支援の高度化です。

    これまでのデータ分析コンペとは一線を画し、生成AIを単なるツールではなく「バディ(相棒)」として捉え、建設業界の実課題に挑むという実践的な内容になっています。

    本記事では、コンペの核心部分である「評価基準」を深掘りし、金融・建設の実務視点から、具体的にどのデータを参照し、どう攻略すべきかのアプローチを整理しました。

    リンク:(金融庁共催)第4回金融データ活用チャレンジ


    評価基準に対する対策(データソース活用)

    本コンペの勝敗を分けるのは、配布された評価視点をいかに深く解釈し、客観的なデータで裏付けられた指示(プロンプト)をAIに出せるかです。

    事務局から提示されている6つの評価視点ごとに、参照すべきデータソースと具体的な対策を見ていきましょう。

    1. 全体構成:過去と未来をつなぐ

    評価視点: 過去分析と未来提案の接続

    評価項目: 過去3年の財務・事業分析と、未来への成長戦略が一貫した因果関係で論理的に接続されているか。

    【対策アプローチ与信管理とベンチマーク】

    最も避けるべきは、現状分析と提案内容の曖昧さです。
    例えば、利益率が悪いのが原因なのに、売上拡大ばかりを提案しても症状は改善しません。

    まずはAIに「デュポン分析」などのフレームワークを使わせ、ROE(自己資本利益率)が悪化している原因が、「儲ける力(収益性)」が低いのか、「資産を使う効率(効率性)」が悪いのかを分解させましょう。

    「どこが悪いか」を特定してから対策を打つことで、説得力のある提案になります。

    その際、対象企業の数値だけを見るのではなく、同規模の同業他社と比較することが重要です。中小企業庁が公開している実態調査などの統計データと比較させ、客観的な「弱点」を抽出してみましょう。

    2. 地域性:その街ならではの解像度

    評価視点: 地域特性の考慮

    評価項目: 企業の所在地(商圏、人口動態、行政施策)を踏まえ、画一的ではない地域密着型の提案ができているか。

    【対策アプローチ:オープンデータの注入】

    建設業は究極の「地産地消」ビジネスです。北海道と沖縄、都市部と過疎地では、求められる工事も経営課題も全く異なります。

    ここでは、国が提供する「RESAS」などの地域経済分析システムを活用するのが定石です。対象企業の商圏における人口推移や産業構造をAIにインプットさせてください。また、各自治体が公表している「総合計画」を参照し、今後その地域で予定されている公共事業や重点施策(防災、インフラ更新など)に絡めた提案を行うと評価が高まります。

    3. 業界特性:商流による戦い方の違い

    評価視点: 販路・商流の理解

    評価項目: 官公庁/民間、元請/下請などの販路特性を把握し、それに応じた具体的な分析・提案となっているか。

    【対策アプローチ:経審と入札制度の理解】

    公共工事が主体であれば、「経営事項審査(経審)」の評点アップが受注への生命線となります。一方で民間が主体であれば、提案力やデザイン力が問われます。

    まずは配布データから企業の立ち位置を分類させましょう。公共主体であれば、国土交通省のサイトで経審の仕組みを理解し、どの項目(財務健全性や技術職員数など)を改善すればランクアップできるかをシミュレーションさせることが有効です。

    4. 業界課題:具体的な技術トレンドへの投資

    評価視点: 近未来への対応 (GX/DX)

    評価項目: 低コスト工法、環境技術(GX)、省力化技術(DX)など、技術トレンドへの投資や対応策を提案できているか。

    【対策アプローチ:NETISの活用】

    単に「DXを推進しましょう」という曖昧な提案では響きません。

    建設業界には「i-Construction」という言葉がある通り、ドローン測量やBIM/CIM、遠隔施工といった具体的な技術が存在します。

    ここで活用したいのが、国土交通省が運用する新技術情報提供システム「NETIS」です。ここにある具体的な新技術をAIに学習させ、「この企業の規模と工種なら、この技術を導入することでこれだけのコスト削減が見込める」といった、具体的かつ専門的な提案を作成しましょう。

    5. 業界課題:2024年問題と人手不足

    評価視点: 需要減退・人材不足対応

    評価項目: 工事需要の変化や深刻な人手不足(2024年問題、外国人材受入等)に対し、実効性のある解決策(歩掛管理の高度化、採用・定着策等)を示せているか。

    【対策アプローチ:制度の正確な理解】

    建設業において、人の数は売上の上限に直結します。特に「2024年問題(時間外労働の上限規制)」への対応は必須です。

    厚生労働省の特設サイトで規制の詳細を確認し、違反リスクを洗い出しましょう。また、人手不足解消の切り札として「特定技能外国人」の受け入れを提案する場合は、出入国在留管理庁の資料を参照し、受け入れ可能な職種や手続きのロードマップを提示すると説得力が増します。

    6. AI活用:相棒としての創造性

    評価視点: AI活用(最終選考のみ)

    評価項目: 生成AIの特性を理解し、独自の視点や創造的なアプローチ(プロンプトの工夫等)により提案書の品質を高めているか。

    【対策アプローチ:ガイドライン準拠と創造性】

    最後に問われるのは、AIの使い方そのものです。

    AIに「金融コンサルタント」「建設業界のアナリスト」「地元商工会議所の担当者」など、複数の役割を与えて議論させるような工夫を取り入れてみましょう。

    また、生成AIの利用にあたっては、日本ディープラーニング協会(JDLA)等のガイドラインを参考に、ハルシネーション(誤情報)への対策や著作権への配慮ができていることを検証レポートで示すことも重要です。


    まとめ:金融と建設のプロとして挑む

    このコンペは、データ分析のスキルを試す場であると同時に、コンサルタントとしての提案力、そしてドメインエキスパートとしての業界理解が問われるイベントです。

    上記のような公的データをAI(RAG等)に読み込ませ、事実に基づいた提案書を作成することで、他の参加者と圧倒的な差をつけることができるはずです。

    Japan Fintech Weekでの登壇を目指して、ぜひ挑戦してみましょう。

  • AIプロジェクトをNotionで管理する方法

    ―― PdM / PM のための実務設計 ――

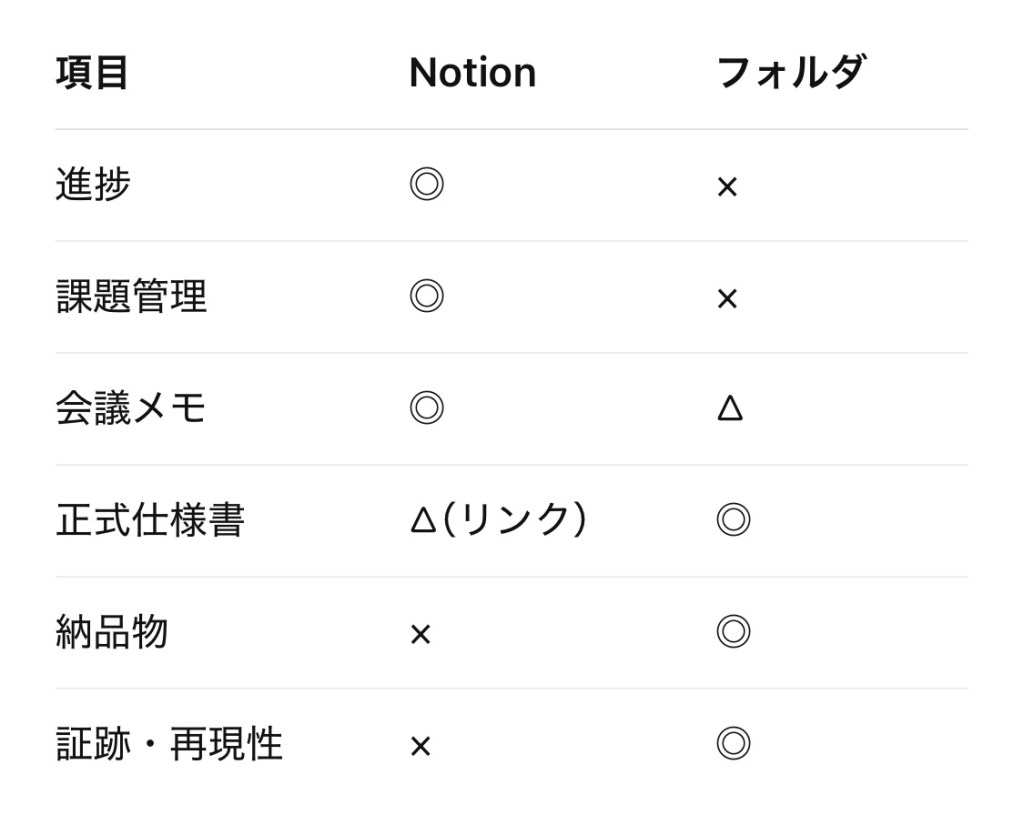
    AIプロジェクトでは、フォルダとNotionは以下のように使い分けます。

    • フォルダ:成果物・証跡・再現性
    • Notion:進行管理・意思決定・コミュニケーション

    本記事では、

    「AIプロジェクト名」から始まる Notion ページの構成をどう設計すべきか

    を、ビジネス実務に即して解説します。


    この記事で分かること

    • AIプロジェクト1件分の Notion ページ構成(完成形)
    • 各ページの役割と「何を書くか」
    • フォルダ管理との正しい棲み分け
    • 日常運用・引き継ぎ・レビューに強い構成

    1. Notionで管理すべきもの/管理しないもの

    Notionで管理するもの

    • 進捗
    • 意思決定
    • 課題・論点
    • 会話・議事メモ
    • 状態(未着手/検討中/完了 など)

    フォルダで管理するもの

    • 納品物
    • 仕様書の正式版
    • モデル・データの成果物
    • 証跡として残すべき資料

    Notionは「生きている情報」、フォルダは「確定した資産」

    これを混ぜないのが最大のポイントです。


    2. Notionの全体構成

    トップページ名

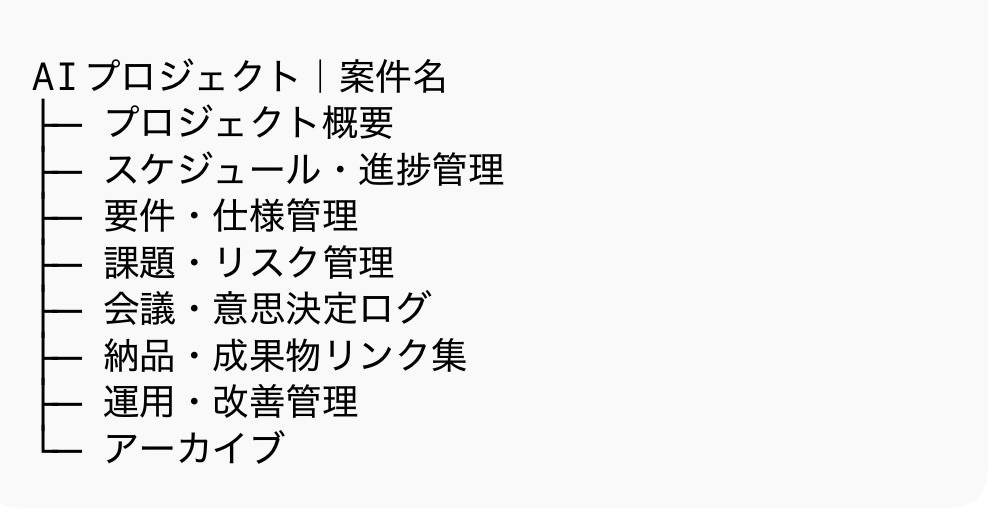
    AIプロジェクト|案件名

    推奨ページ構成(完成形)

    以下、1ページずつ「目的」「書く内容」「使いどころ」を説明します。


    3. 各ページの役割と中身

    ① プロジェクト概要

    目的:誰でも5分で全体像を理解できる

    書くこと

    • プロジェクト目的・背景
    • 業務課題と狙い
    • 成功指標(KPI)
    • スコープ(やる/やらない)
    • 関係者(責任者・承認者)

    ポイント

    • フォルダの「00_プロジェクト概要」と内容は対応させる
    • Notionは要約、フォルダは正式文書

    ② スケジュール・進捗管理

    目的:今どこにいて、何が遅れているかを一目で把握

    書くこと

    • フェーズ一覧(要件定義/設計/開発/検証/納品/運用)
    • マイルストーン 各タスクのステータス(未着手/進行中/レビュー中/完了)
    • 担当者

    使いどころ

    • クライアントとの進捗共有
    • 社内定例の進捗確認

    ③ 要件・仕様管理

    目的:認識ズレを防ぎ、判断軸を固定する

    書くこと

    • 業務要件(要点のみ)
    • AI要件(提供価値)
    • 前提条件・制約 仕様変更ログ(いつ・なぜ変えたか)

    重要

    • 「なぜこの判断をしたか」を必ず残す
    • 詳細仕様はフォルダにリンク

    ④ 課題・リスク管理

    目的:問題を早期に可視化し、属人化を防ぐ

    書くこと

    • 課題内容
    • 影響範囲(品質/スケジュール/コスト)
    • 対応方針
    • ステータス
    • 担当者

    典型例

    • データ欠損が多い
    • 想定精度に届かない
    • クライアント判断待ち

    ⑤ 会議・意思決定ログ

    目的:あとから「なぜそうなったか」を説明できる状態にする

    書くこと

    • 会議日付
    • 議題
    • 決定事項
    • 保留事項
    • 次アクション

    強い理由

    引き継ぎ・炎上時・監査対応で最も価値が出る

    ⑥ 納品・成果物リンク集

    目的:成果物の所在を迷わせない

    書くこと

    • フォルダ(SharePoint / Drive 等)へのリンク
    • 納品物一覧
    • バージョン
    • 納品日

    注意

    Notionにファイルを直接溜めず、あくまで「リンク集」。

    ⑦ 運用・改善管理

    目的:納品後もAIを使い続けられる状態にする

    書くこと

    • 運用ルール(誰が・いつ・何を見るか)
    • モニタリング指標
    • 改善アイデア・要望
    • 再学習や改修の検討ログ

    ポイント

    運用が始まると、ここが一番使われる

    ⑧ アーカイブ

    目的:終了後も判断履歴を残す

    書くこと

    • 完了済みタスク
    • 終了した議論
    • 過去フェーズの情報

    運用

    基本は参照のみ 編集禁止でもOK


    4. フォルダ管理との正しい棲み分け

    Notionはハブ、フォルダは保管庫


    5. PdM / PM がやるべき初期セットアップ手順

    • 「AIプロジェクト|案件名」ページを作成
    • 上記8ページをすべて作る(中身は空でもOK)
    • プロジェクト概要だけは最初に埋める
    • 定例MTGの議事メモを必ず Notion に残す
    • 週1回、課題・進捗ページを更新する

    これだけで プロジェクトの透明性が一気に上がります。


    6. よくある失敗と対策

    • ❌ Notionに資料を全部置く → ⭕ フォルダへのリンクだけ置く
    • ❌ ページが増えすぎて迷子 → ⭕ プロジェクト単位で1トップ構成にする
    • ❌ 更新されなくなる → ⭕ 定例会のアジェンダをNotion固定にする

    7. まとめ

    AIプロジェクトの成功は、

    モデルの性能より「管理の設計」で8割決まる

    と言っても過言ではありません。

    • フォルダ:会社の資産として残す
    • Notion:プロジェクトを前に進める

    この2つを分けて設計できれば、

    PdM / PM としての再現性は一気に高まります。


    AIプロジェクト用Notionテンプレ

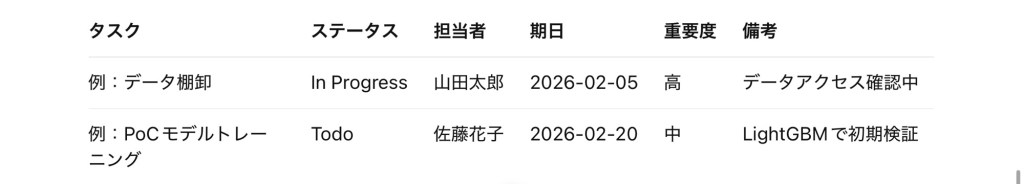
    ※必要に応じて、テーブル部分を選択して右上メニュー → 「変換」→「データベース」にすると管理が楽になります(Tasks は Board、Issues は Table など推奨)。


    AIプロジェクト

    ステータス:(未着手 / 進行中 / 停滞 / 完了)

    プロジェクトリード:

    クライアント / 事業部:

    主要KPI(Success Criteria):

    主要マイルストーン:

    M1:要件合意(YYYY-MM-DD)

    M2:PoC完了(YYYY-MM-DD)

    M3:本番リリース(YYYY-MM-DD)


    目次

    • プロジェクト概要
    • スケジュール・進捗
    • 要件・仕様
    • 課題・リスク
    • 会議・意思決定
    • 納品・成果物
    • データカタログ
    • モデル仕様
    • 運用・モニタリング
    • アーカイブ

    プロジェクト概要

    目的(1行):

    背景(要点):

    期待効果 / ビジネスインパクト:

    スコープ(やること):

    除外事項(やらないこと):

    関係者(役割・承認者):

    • プロジェクト責任者(承認):
    • PdM / PM(運営):
    • データエンジニア:
    • データサイエンティスト:
    • 業務担当(利用者):

    スケジュール・進捗— タスク管理

    推奨フィールド:タイトル / ステータス(Backlog・Todo・In Progress・Review・Done) / 担当者 / 期日 / 重要度 / 関連(リンク)

    運用ルール:週次(または定例)でステータス更新。PdMが週1でレビューして未更新項目をピックアップする。


    要件・仕様

    業務要件(要約):

    • 目的・現行フロー(簡潔に) AI要件(提供価値):
    • 何を出力するか / どう使うか(例:来週の客数予測、CSVで提供、店舗別) 成功基準(Acceptance / KPI):
    • 例:来週の客数を±10%以内で把握できること(責任者:○○) 制約:データ、法務、時間、予算など

    課題・リスク

    推奨フィールド:ID / 課題タイトル / 種別(課題/リスク) / 影響範囲 / 優先度 / 状態 / 担当 / 対応期限 / 対応方針

    運用ルール:新課題は即登録。重大リスクは週次でエスカレーション(誰に報告するかを明記)。


    会議・意思決定ログ

    会議テンプレ(コピーして使用)

    会議名:

    日時:

    参加者:

    アジェンダ:

    1.

    2.

    決定事項:

    D-001:決定内容(責任者、期限) 保留事項: アクション: タスク(担当/期日)

    ルール:議事録は会議終了24時間以内に記載。決定事項は Decisions に要約して記録(ID付与)。


    意思決定

    ID

    日付

    決定事項

    影響範囲

    決定者

    参照会議

    D-001

    2026-01-30

    PoCは手動運用で検証する

    運用方式

    事業責任者A

    MTG_2026-01-29


    納品・成果物

    ここにはフォルダ(共有ドライブ)へのリンクを並べる(Notion内にファイルを置かない)

    納品一覧

    • v0.1_PoC出力(リンク) — 2026-02-21
    • v1.0_本番出力(リンク) — 予定日:2026-03-31
    • 利用ガイド(リンク)
    • 受け入れ基準(リンク)

    運用・モニタリング

    運用フロー(要点):

    • 日次:データ受領確認(担当:)
    • 週次:モデル指標確認(担当:)
    • 月次:精度レビュー(PdM/PMと業務担当)

    モニタリング指標(例):予測誤差(MAE)、データ欠損率、出力件数、利用頻度

    インシデント対応フロー:発見→暫定対応→影響調査→恒久対策→報告(誰へ)

    再学習計画:条件(例:MAEが閾値超過、データ量がX%増加)/手順の要約へのリンク


    アーカイブ

    • 完了済みタスクの要約
    • 廃止モデルの理由と参照先
    • 過去の重要決定のログ (参照専用。編集は制限推奨)

    便利なテンプレ

    ミーティング議事録テンプレ

    会議名: 日時: 参加者: アジェンダ: 1. 2. 決定事項: - D-XXX: (短い説明) — 決定者:/期限: アクション: - [ ] タスク名 — 担当: — 期日:

    意思決定テンプレ

    ID:D-XXX 日付: 決定内容(短文): 背景(要点): 影響(スコープ): 決定者: 参照(会議名/ドキュメント): フォローアップ(アクション/担当/期日):

    課題テンプレ

    ID:I-XXX タイトル: 種別(課題/リスク): 詳細: 影響範囲: 優先度(高/中/低): 状態(Open/In Progress/Resolved): 担当: 対応期限: 対応方針: 履歴:

    引き継ぎチェックリスト

    - [ ] プロジェクト概要を読む(00_プロジェクト概要) - [ ] AI要件を確認(01_要件定義) - [ ] 出力仕様を確認(02_設計) - [ ] モデル仕様を確認(04_モデル) - [ ] 運用フローを読む(06_運用) - [ ] 現在の重要課題(Issues)を把握 - [ ] 引継ぎ完了日を記載して署名

  • AIプロジェクトのフォルダの作成方法

    ―PdM/PM が会社資産として残すための実務手順 ―

    AIプロジェクトは「モデルが動いたら終わり」ではありません。

    重要なのは、誰が見ても分かり、引き継げる状態でプロジェクトを保存することです。本稿は、ビジネス実務者(PdM/PM/事業責任者)が主体となってプロジェクトフォルダを設計・運用するための手順を解説します。


    本ブログで得られること

    • 会社に残すべきフォルダ構成
    • 各フォルダに必ず置くべきドキュメントとその目的
    • 運用ルール(命名規則、権限、バックアップ)
    • 引き継ぎチェックリストとガバナンスの運用方法
    • よくある失敗と対策

    1. 設計方針(最初に決めるべき考え方)

    • 業務ファースト:何のためのAIなのか(誰が何をどう改善するか)を起点にする。
    • 可視化・説明責任:判断根拠と意思決定の履歴を残す。
    • 再現性:将来の改善や再現ができることを前提にドキュメント化する。
    • 運用前提:納品=終わりではなく、運用・監視・改善までを設計する。

    これらの設計方針を書面で固定してからフォルダを作成します。


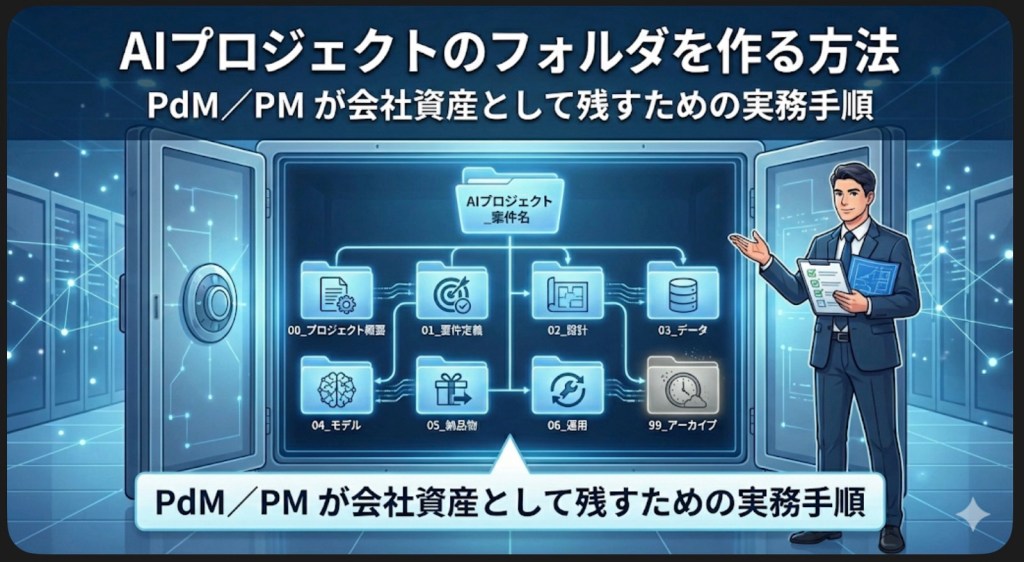
    2. 推奨フォルダ構成

    まずトップレベルの名前は「AIプロジェクト_案件名」として下記構成を推奨します。

    • 00_プロジェクト概要
    • 01_要件定義
    • 02_設計
    • 03_データ
    • 04_モデル
    • 05_納品物
    • 06_運用
    • 99_アーカイブ

    各フォルダの役割は次節で詳述します。命名は日本語で統一し、並び順が自然にプロジェクトの時系列(概要→要件→設計→実装→納品→運用→履歴)になるようにします。


    3. 各フォルダに入れるべきもの

    00_プロジェクト概要

    目的:

    初めて触る人が1分で理解できる要約を置く場所。

    必須ドキュメント:

    プロジェクト概要(目的・背景・期待効果)、成功条件(業務KPI)、スコープ(やらないこと明示)、関係者一覧(責任者・承認者・連絡先)、ロードマップ(主要マイルストーン)。

    使い方:

    キックオフ資料として常に最新版を置く。主要変更は履歴を残す。

    01_要件定義

    目的:

    クライアント/事業側の要求を業務に効く形で固定する。

    必須ドキュメント:

    業務要件(現状フロー・課題)、AI要件(何を提供するか、提供しないこと)、成功基準(KPI の数値や採用判定基準)、制約(データ・法務・予算・期限)。

    使い方:

    実装や評価がブレたらここに立ち戻り、判断軸として参照する。

    02_設計

    目的:

    実装チームが迷わず作業できる設計を残す。

    必須ドキュメント:

    システム構成(図)、入出力仕様(誰がどの形式で受け取るか)、運用前提(バッチ頻度、遅延許容)、UI/レポート仕様(画面や帳票のサンプル)。

    使い方:

    実装前の合意書。設計変更は差分を明記。

    03_データ

    目的:

    データの由来・定義・問題点を誰でも追える状態にする。

    必須ドキュメント:

    データ一覧(ソース・更新頻度・保存場所)、データ定義(カラム説明・単位)、前処理ルール(欠損・外れ値の扱い)、データ課題ログ(発見→対応履歴)。

    注意点:

    個人情報や機微情報の扱いは法務ポリシーに従うこと。

    04_モデル

    目的:

    モデルの選定理由・性能・制約を業務側が理解できる形で残す。

    必須ドキュメント:

    モデル仕様(目的・入力・出力・想定利用)、評価レポート(評価指標と解釈、限界)、再現手順(誰でも同じ結果をたどるための概要)、依存関係(環境の要点)。

    使い方:

    モデル更新・再学習の根拠と履歴管理に使う。

    05_納品物

    目的:

    クライアントが業務に取り入れられる形で成果を届ける。

    必須ドキュメント:

    納品サンプル(出力例)、利用ガイド(業務担当者向け操作・解釈ルール)、受け入れ基準。

    使い方:

    契約上の検収資料・利用トレーニングに使用する。

    06_運用

    目的:

    納品後もAIが安定して使われるための運用設計を置く。

    必須ドキュメント:

    日常運用フロー(誰がいつ何をチェックするか)、モニタリング指標(主要KPI・データ品質指標)、再学習計画(トリガー条件、頻度)、障害履歴(インシデントログ)。

    運用ルール例:

    週次チェックの担当・頻度を明示する(例:毎週月曜に○○が指標確認)。

    99_アーカイブ

    目的:

    過去の判断や旧仕様を保存し、理由を辿れるようにする。

    必須ドキュメント:

    旧仕様、廃止モデル、過去の議事録・意思決定メモ。

    運用:

    アーカイブは読み取り専用にする・削除は管理者承認にする。


    4. 実務上の運用ルール(PdM/PM が決めるべき事項)

    • 保存場所の決定:会社の標準共有領域(例:SharePoint/Google Drive/Box)を使用。コードは別にGit管理する運用方針を明記。
    • アクセス設計:編集権限はコアメンバーに限定。閲覧は広め。重要操作(削除など)は管理者承認。
    • 命名規則:ドキュメントは「YYYY-MM-DD_内容_vX.Y」の形式で保存。ファイル名に日付を必須化。
    • ファイル形式:ドキュメントは Markdown(.md)か PDF、表は Excel。理由:差分と検索性。
    • 変更管理:主要ドキュメントの更新は「変更履歴」を残す。大きな設計変更は承認フローを通す。
    • バックアップ:重要フォルダは週次でスナップショットを残す。
    • オンボーディング:新担当向けチェックリストを整備(後述)。
    • 遵守事項:個人情報保護、契約・法務の制約は必ず添付して運用する。

    5. 引き継ぎ・オンボーディングチェックリスト(必須)

    新しい担当者が来たときの「初日5分チェック」:

    • 00_プロジェクト概要の「プロジェクト概要」を読む(目的・KPI・スコープ)
    • 01_要件定義の「AI要件」で期待されるアウトカムを確認
    • 02_設計の「出力仕様」を確認(納品物の形式)
    • 04_モデルの「モデル仕様」で利用上の制約を把握
    • 06_運用の「運用フロー」で定常作業を把握(週次・月次の担当)

    引き継ぎ完了時は「引継ぎ完了チェックリスト」に担当者名と日付を記録しておく。


    6. よくある失敗パターンと対策(実務の教訓)

    • READMEだけ作られて中身が空 → 対策:必須ドキュメント一覧を定義し、未完はTODOラベルを付けて週次で消化する。
    • データが担当者PCに散在 → 対策:生データは必ず会社クラウドへ。手元にある場合のルールを明示(消去・転送手続き)。
    • コードはあるが実行環境が不明 → 対策:依存関係や実行手順は必須欄にする。運用担当が実行できるレベルの要約を付ける。
    • 運用ルールがないため納品後放置 → 対策:運用フローを納品条件に含め、検収時に運用トレーニングを実施。
    • 誰が意思決定するか不明 → 対策:関係者一覧に「意思決定者」「承認者」を明記し、意思決定フローを図示する。

    7. すぐ使える短縮チェックリスト(PdM/PM 用:今すぐやること)

    1. プロジェクトルート(AIプロジェクト_案件名)を作る(共有領域上)
    2. 00_プロジェクト概要に「プロジェクト概要」「関係者一覧」「ロードマップ」を置いてチームに通知
    3. 01_要件定義に「業務要件」「AI要件」を入れてクライアント承認を得る
    4. 02_設計に「出力仕様」を入れて、業務側とサンプル出力で確認
    5. 06_運用に「週次チェック項目」と担当者を決める
    6. 引き継ぎチェックリストを作り、リポジトリに置く

    これだけでプロジェクトの透明性は大きく改善します。


    8. 提案(PdM/PM の運用改善アクション)

    • 毎週の短い「ドキュメント・デッドライン」を設定(例:水曜17:00に週次更新)。
    • 月次でドキュメント監査(未完リストを確認・割当)。
    • 重要ドキュメントはレビュー承認者を決める(臨時変更は承認必須)。
    • 初回納品時に「運用トレーニング」と「操作マニュアル」を必須で実施させる。

    9. まとめ(ビジネスでの価値)

    フォルダを作ること自体は簡単です。しかし真の価値は、そのフォルダが組織で使われ続け、引き継がれることにあります。PdM/PM は「フォルダ作成者」ではなく「フォルダを生きた資産にする人」。まずは「プロジェクト概要」を完成させてチームに共有することを今日のアクションにしてください。

  • AIプロジェクトの納品物って?

    前ブログに続いて、今回はAIプロジェクトのPdM / PM が抑えるべき納品物について書きます。

    今回もchatGPT先生にご意見いただきました。


    ― PdM / PM が最初に押さえるべき観点 ―

    AIプロジェクトの納品物は3種類

    AI案件の納品物は、大きく分けて以下の3つです。

    1. 意思決定者向けの納品物(業務で使うもの)
    2. 運用・保守のための納品物(継続させるもの)
    3. 技術的な納品物(再現・改善するもの)

    PdM / PM は、

    この3つが揃っているかを常に確認する役割です。


    ① 意思決定者向けの納品物(最重要)

    1. AIのアウトプット(画面・帳票・API)

    最も重要なのは、

    AIの結果そのものです。

    • 予測値・スコア
    • 推奨アクション
    • リスク判定結果 など

    ここで重要なのは、

    精度よりも「使える形」になっているかです。

    例:

    • CSVで渡すのか
    • BIツールで見るのか
    • 管理画面で確認するのか

    2. 利用ルール・判断ガイド

    AIは「参考情報」であることが多いです。

    そのため、

    どう使うかのルールが必須になります。

    • この数値が出たらどう判断するか
    • 使ってはいけないケース
    • 人が最終判断すべきポイント

    これがないと、

    「結局使われないAI」になります。


    ② 運用・保守のための納品物

    3. 運用フロー・業務手順書

    誰が いつ 何を確認し どう対応するか

    AIを組み込んだ後の業務フローを明文化します。

    PdM / PM が関与しないと、ここが抜け落ちがちです。


    4. モニタリング指標・運用KPI

    納品して終わり、ではありません。

    • 精度は劣化していないか
    • データは正常か 利用されているか

    最低限、以下は定義します。

    • モデル評価指標
    • データ異常検知
    • 利用頻度

    ③ 技術的な納品物(現場向け)

    5. 学習・推論コード一式

    • 学習コード
    • 推論コード
    • 設定ファイル

    「誰が見ても再現できる状態」

    になっていることが重要です。


    6. データ定義・前処理仕様

    • 使用データ一覧
    • カラム定義
    • 前処理ルール

    ここが曖昧だと、将来の改善が止まります。


    7. モデル仕様書(軽量でOK)

    数十ページの立派な資料は不要です。

    最低限、

    • モデルの目的
    • 入力データ
    • 出力内容
    • 制約・注意点

    これだけで十分です。


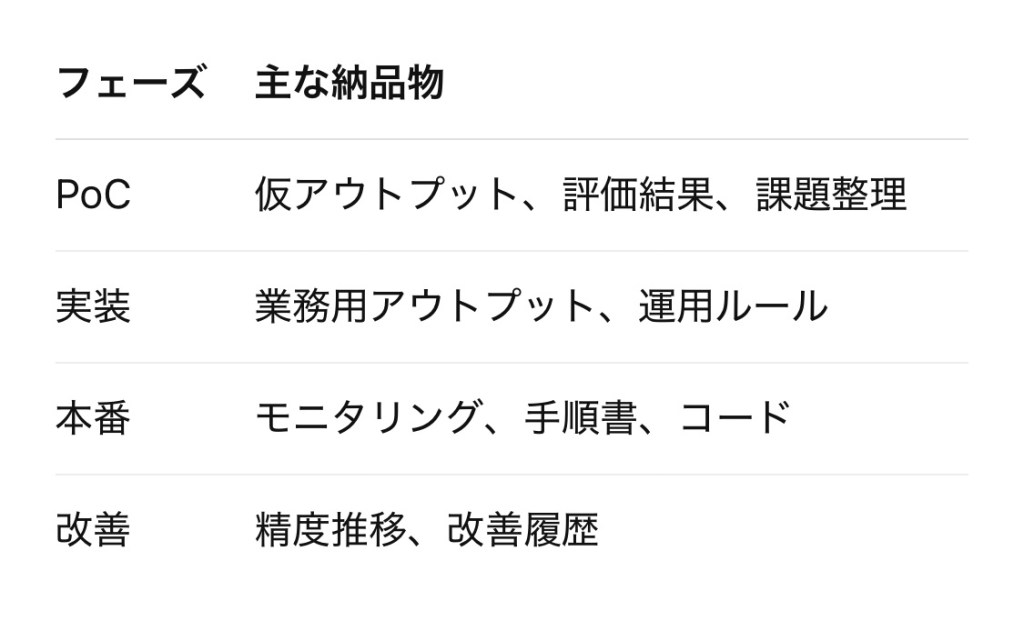
    フェーズ別:納品物の対応関係


    PdM / PM が見るべきチェックポイント

    • クライアントは「使い方」を理解しているか
    • 運用担当が困らない状態か
    • 技術的にブラックボックス化していないか

    まとめ

    AIプロジェクトの納品物とは、

    AIモデルそのものではありません。

    「業務で使い続けられる状態」

    それ自体が納品物です。

    PdM / PM の価値は、

    この全体像を設計できることにあります。


    いいですね。

    今回に関しては、自分の想像を超えない範囲でした。

    いかかでしたでしょうか?

    前回の記事とあわせて読むことで、

    仕事の進め方から納品物まで、

    AIプロジェクトの全体像がひと通り見えたのではないかと思います。

    AIプロジェクトは、作って終わりではなく、開発と運用のサイクルで改善され続けてはじめて意味があります。

    そのために、PdM / PM が何を考えて用意していくべきか。

    この記事が、これからAIプロジェクトに関わる方のご参考になれば幸いです。

  • AIプロジェクトのPdM/PMを任された人が、最初に読むべき実践記事

    AIプロジェクトの

    プロダクトマネージャー(PdM)兼プロジェクトマネージャー(PM)

    を任されました。

    クライアントの要望を整理し、

    AIプロダクトの開発を進め、

    進捗を共有し、課題を洗い出し、

    チームに仕事を割り振る。

    ……頭で断片的に理解していても、何に注意して動いて行けばいいかわからない笑。

    この記事では、

    AIプロジェクトで破綻しないための仕事の進め方を、実務目線で整理します。

    はい、僕向けです 笑。

    読者様も、同じ経緯でこの記事に思うので、少しでも参考になれば幸いです。

    (以下、僕の強い味方であるchatGPT様のご意見です。)


    AIプロジェクトのPdM兼PMは難易度が高いですが、型を持てば一気に楽になります。

    あなたのこれまでの データ・ML実務(LightGBM ) の経験は、かなり武器になります。

    以下は「明日からこの順で動けば破綻しない」実践フレームです。


    全体像(まずはこれを頭に入れる)

    あなたの役割は 3つの翻訳者 です。

    その1. クライアントの曖昧な要望 を 解ける問題 に翻訳

    その2. 解ける問題 を AIプロダクトの仕様 に翻訳

    その3. 仕様 を チームの具体タスク に翻訳

    この翻訳がうまくいけば、進捗・信頼・成果がすべて回ります。


    ① 最初にやるべきこと(着任直後)

    1. ゴールを「ビジネスKPI」で固定する

    AIの精度ではなく、意思決定に使えるかが基準です。

    必ず決める質問

    • このAIで「何を良くしたい?」(売上?工数?リスク?)
    • 誰が、いつ、どの判断に使う?
    • 使えなかったら何が困る?

    👉 例(良い形)

    「週次の発注量を決める担当者が、

    来週の客数を±10%以内で把握できること」

    ※ 精度目標(RMSEなど)は後で決める

    2. 「やらないこと」を決める(超重要)

    AI案件は膨張するのが失敗パターン。

    • 今回は 自動化しない
    • 今回は リアルタイムはやらない
    • 今回は 全店舗対応しない

    👉 これを最初にクライアントと合意


    ② クライアント要望 → プロジェクト設計

    要望整理テンプレ(そのまま使えます)

    ① 背景・課題 ② 期待しているアウトカム(業務レベル) ③ 現在の業務フロー(AIなし) ④ AIが入るポイント ⑤ 成功条件(定量・定性) ⑥ 制約(期限 / データ / 予算 / 法務)

    これを1枚にまとめて、

    👉 「この理解で合ってますか?」レビューを必ず入れる。

    AIプロジェクト特有の注意点

    最初に確定できないもの

    • 精度
    • 学習に使えるデータの質
    • 特徴量の有効性

    だからこそ👇

    「段階的に確度を上げる前提」をクライアントに説明


    ③ スケジュールの作り方(鉄板)

    AI案件の王道フェーズ

    Phase 0:業務理解・データ棚卸(1〜2週)

    • 使えるデータは何か
    • 欠損・粒度・履歴
    • 業務的に「使えない」値は?

    👉 この時点で赤信号が出る案件は多い

    Phase 1:PoC(まずは動くもの)(2〜4週)

    • 精度より「方向性」
    • シンプルなモデル(線形 or LightGBM)
    • 手動運用OK

    👉 クライアントには

    「これは検証用です」と明言

    Phase 2:業務で使える形へ(4〜8週)

    • 特徴量改善
    • 精度評価
    • UI / 出力形式調整
    • 運用ルール作成

    Phase 3:本番・改善サイクル

    モニタリング 精度劣化検知 再学習計画


    ④ 進捗共有・クライアントとの会話術

    進捗報告は「事実+判断」

    ❌ 悪い例

    「精度が思ったより出てません」

    ⭕ 良い例

    「現状、祝日影響が強く残っています

    → 特徴量追加で改善見込みあり

    → 1週間追加で検証したいです」

    毎回伝える3点セット

    • 今どこ?(事実)
    • 何が課題?(仮説)
    • どうする?(選択肢)

    👉 クライアントに「決断」をしてもらう


    ⑤ チームへの仕事の渡し方

    タスクは「判断不要レベル」まで落とす

    ❌「特徴量を考えて」

    ⭕「祝日影響を見るために・祝日前後±3日のフラグ・曜日×祝日交互作用を作って、CVで比較して」

    役割分担の基本

    あなた:全体設計・判断・対外調整

    ML:モデル・特徴量・評価

    DE:データ整備・パイプライン

    Biz:業務要件・使い勝手


    ⑥ あなたが毎週やるべきチェックリスト

    1. クライアントの期待はズレていないか?
    2. 「精度」ではなく「使えるか」を見ているか?
    3. 次の意思決定は誰がするのか明確か?
    4. チームは迷わず作業できているか?

    最後に(かなり重要)

    あなたは

    「AIを作る人」ではなく

    「AIで失敗させない人」です。

    技術力よりも

    • 問題設定
    • 期待値調整
    • 意思決定の整理

    ここができるPdM/PMは本当に希少です。


    ・・・。

    GPT先生さすがです…とても勉強になりました。

    自分の担当するプロジェクトでも、当てはまる課題も共通していて、とても共感しました。

    今後は PdM/PMとして、

    プロジェクトの進行は①〜③を、

    プロジェクト進行中に④〜⑥を

    参考にしたいと思いました。

    次のブログでは、前職が製造業界で、仕事の完了=納品を意識していた関係で、

    プロジェクトでの成果物/納品物って何?

    と気になったので、それについて書きます。

  • 仕事で使える便利ツール(自分用メモ)

    ※随時更新

    目新しいものは、ないと思われます!

    ご了承下さい🙇

    必須級

    Claude

    コード最強、要求を完璧に受け止めつつ、更に上質なコードを提供してくれる。

    Gemini

    回答の表現がいい。メール文章を依頼するのに重宝します。

    chatGPT

    普段使い。気軽に頼める。

    Notion

    プロジェクト管理

    資料作成向け

    NotebookLM

    たまに文字おかしいけど、普通に優秀。まだ使いこなせてない感。

    gen-sperk

    編集可能なスライドを作ってくれる。細かい修正も◎

    Manus

    高性能。ただ、クレジットが秒でなくなる。

    アーキテクチャ設計向け

    Draw.io

    システム構成図・データフロー図作成。ベースはアーキの得意なGPTに質問してXML形式で出力。

    コード・データ分析向け

    Google Colab

    検証から開発も出来る。GPUもある。

    VS Code

    データの修正とか?最近はあまり使わないかも。

    クリエイティブ

    Google studio

    あまり使ってないけど、簡単なアプリなら作れるらしい。